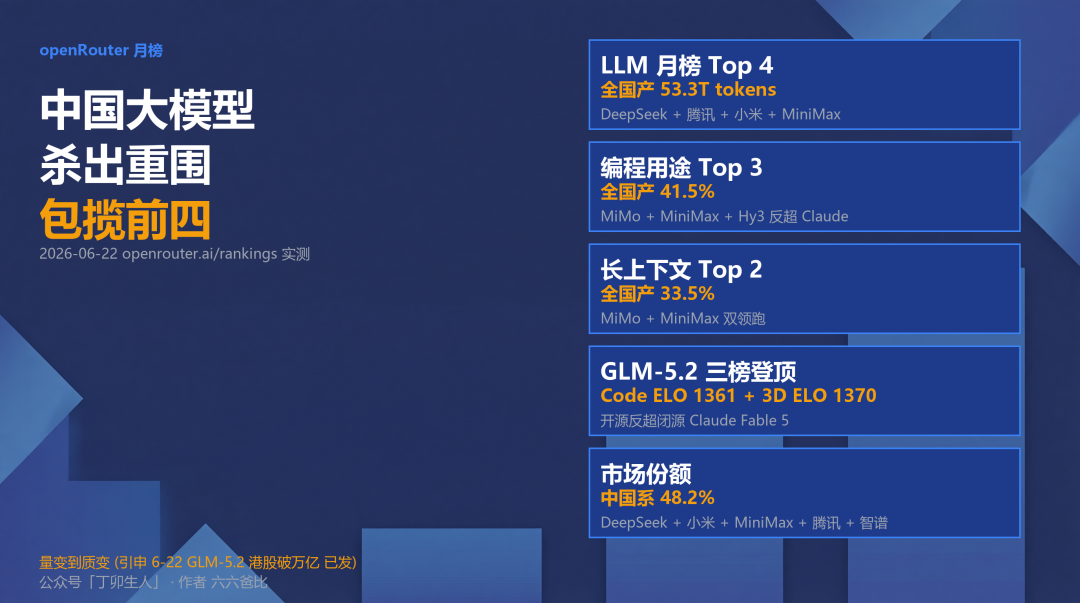
openRouter 月榜:中国大模型杀出重围 包揽前四
大家好我是六六爸比,一个85后科技IT爱好者。
OpenRouter 月榜观察
2026-06-22 | 数据来源 openrouter.ai/rankings
你以为 OpenRouter 这种全球 API 市场 Top 4 必有 Anthropic 一席吧?
我看完 27 张图表发现,前四全是国产开源 LLM。中国 LLM 在 OpenRouter 上到底是真崛起还是昙花一现,我把 5 大榜拆开给你看。
一、LLM 月榜:中国系包揽前四
月榜 Top 4 完整名单:
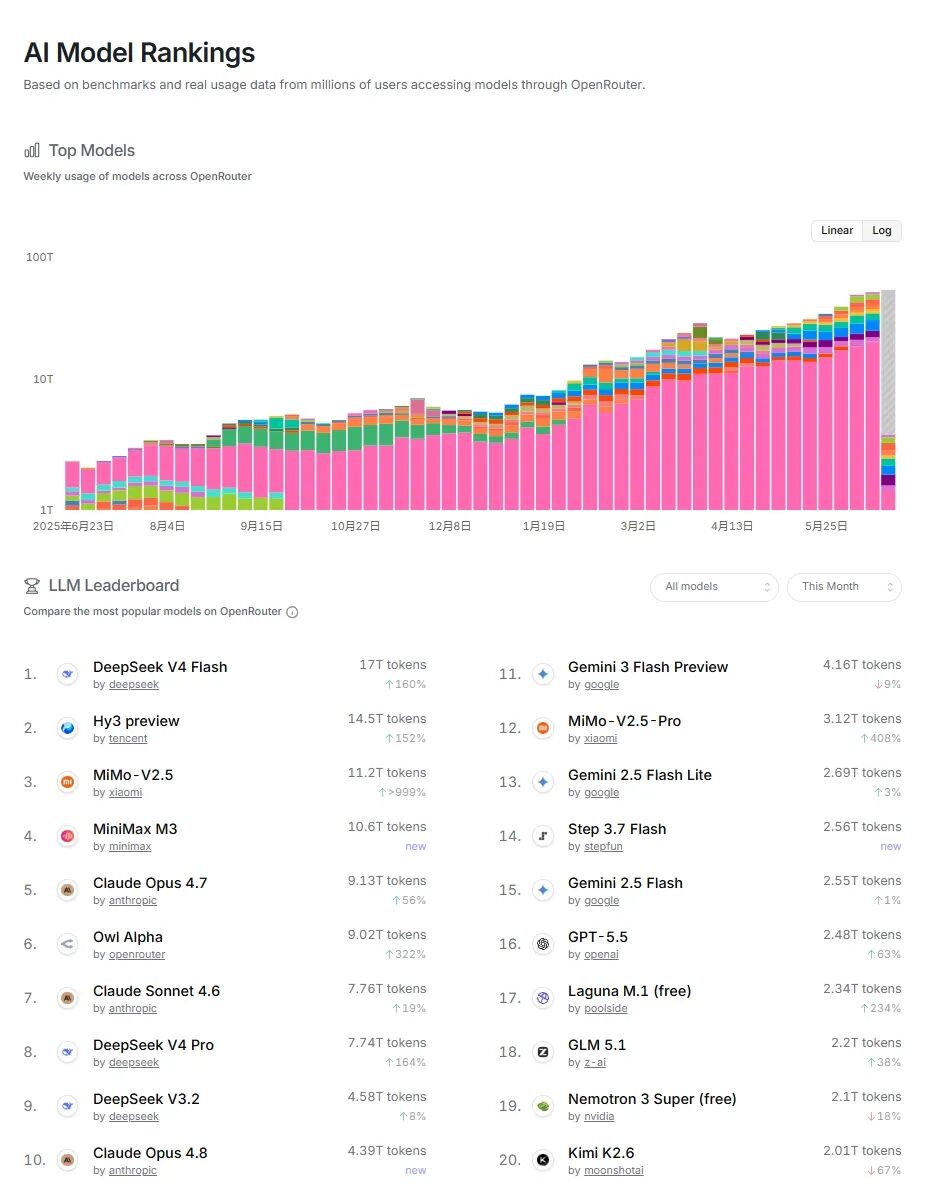
DeepSeek V4 Flash 17T tokens 登顶,是 Anthropic Claude Opus 4.7(9.13T)的近两倍。第二腾讯 混元 preview 14.5T,第三小米 MiMo-V2.5 11.2T,第四 MiniMax M3 10.6T。Claude Opus 4.7 9.13T 只能排第五。
这 4 款都是开源或开源协议模型,且都来自中国厂商。我之前一直以为 OpenRouter 是 Anthropic 的主场——毕竟 Claude 系列在编程和长文领域口碑一直很稳。月榜数据把我之前的认知直接打脸。
看图小贴士:截图右下角"new"标签 = 新发布模型;箭头颜色绿 = 上涨,红 = 下跌。DeepSeek V4 Flash 17T 是 Anthropic Claude Opus 4.7(9.13T)的近 2 倍。
二、编程用途:中国开源 LLM 反超闭源
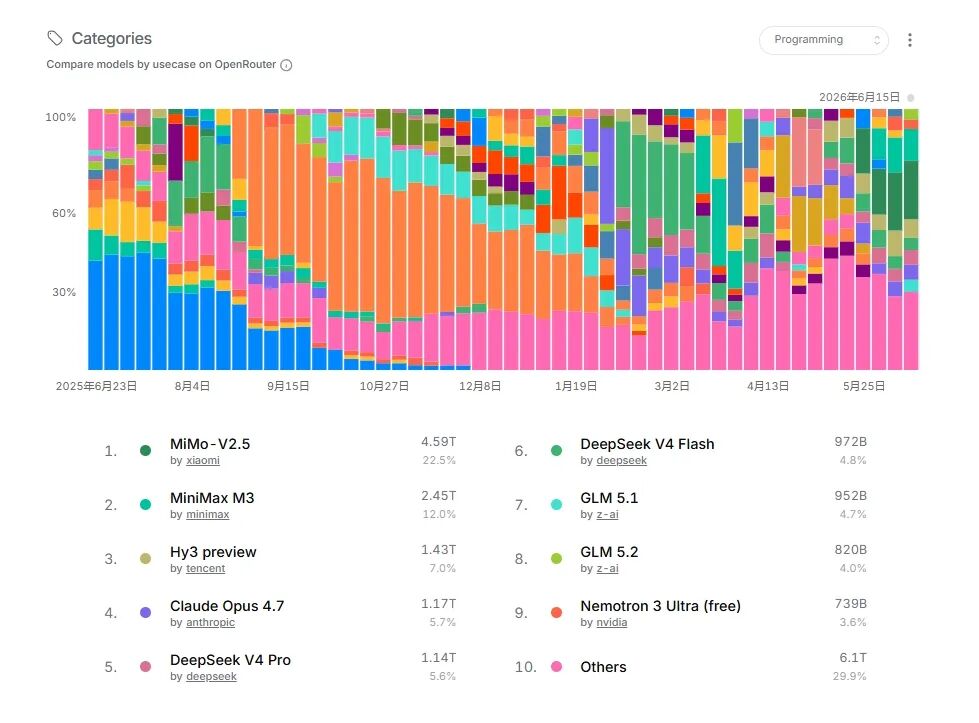
编程类目使用量榜:小米 MiMo-V2.5 占 22.5%,MiniMax M3 占 12.0%,腾讯混元占 7.0%,前三合计 41.5%。Anthropic Claude Opus 4.7 在编程类目只有 5.7% 排第四。
我之前一直以为编程是 Claude 的铁王座,结果 ELO 评测和实际使用量两边都被中国开源反超。这种"专业榜单被国产开源压制"的情况,在 2024 年是不可想象的。
看图小贴士:截图横跨约 1 年时间(2025-06 至 2026-06),堆叠条形 100% 归一化,能清晰看到不同模型在不同时段的份额演变。Top 1 MiMo-V2.5(22.5%)和 Top 2 MiniMax M3(12.0%)差距 10 个百分点,但前 3 合计 41.5%。
三、长上下文:MiMo + MiniMax 双双领跑
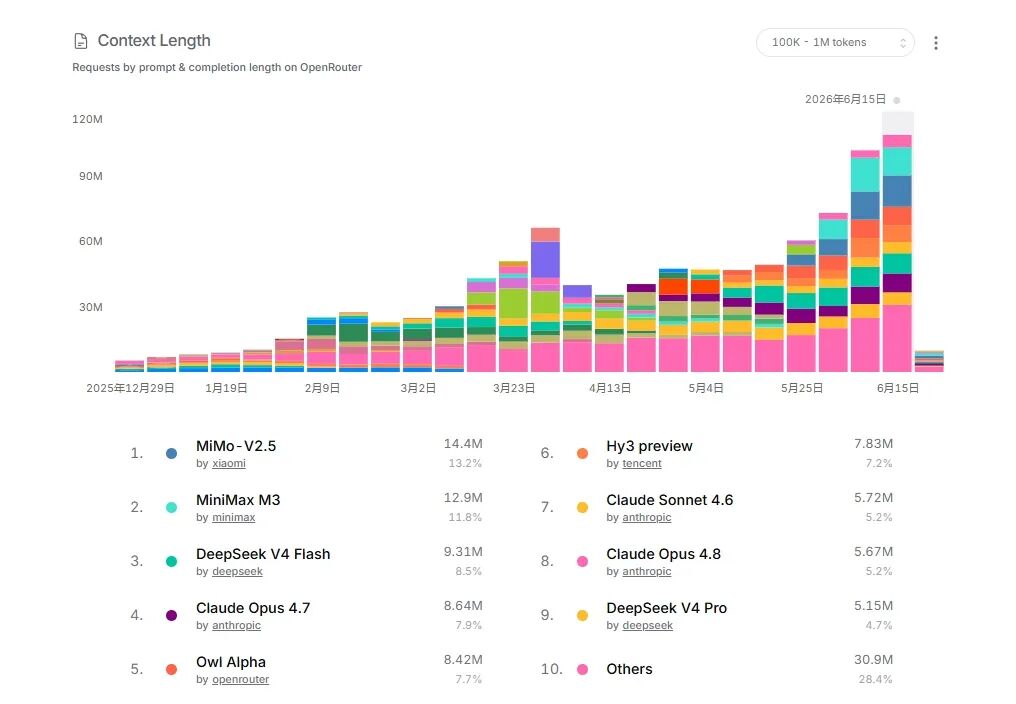
100K-1M tokens 长上下文请求榜:小米 MiMo-V2.5 13.2% 第一,MiniMax M3 11.8% 第二,DeepSeek V4 Flash 8.5% 第三,Claude Opus 4.7 7.9% 第四。
中国开源 LLM 在长上下文场景的份额(MiMo + MiniMax + DeepSeek 合计 33.5%)甚至超过了美系总和。这说明国产 LLM 在长文档分析、代码库理解这类场景已经站稳脚跟,不是测试集好看而已。
四、Benchmarks:GLM-5.2 三榜登顶(可用模型第一)
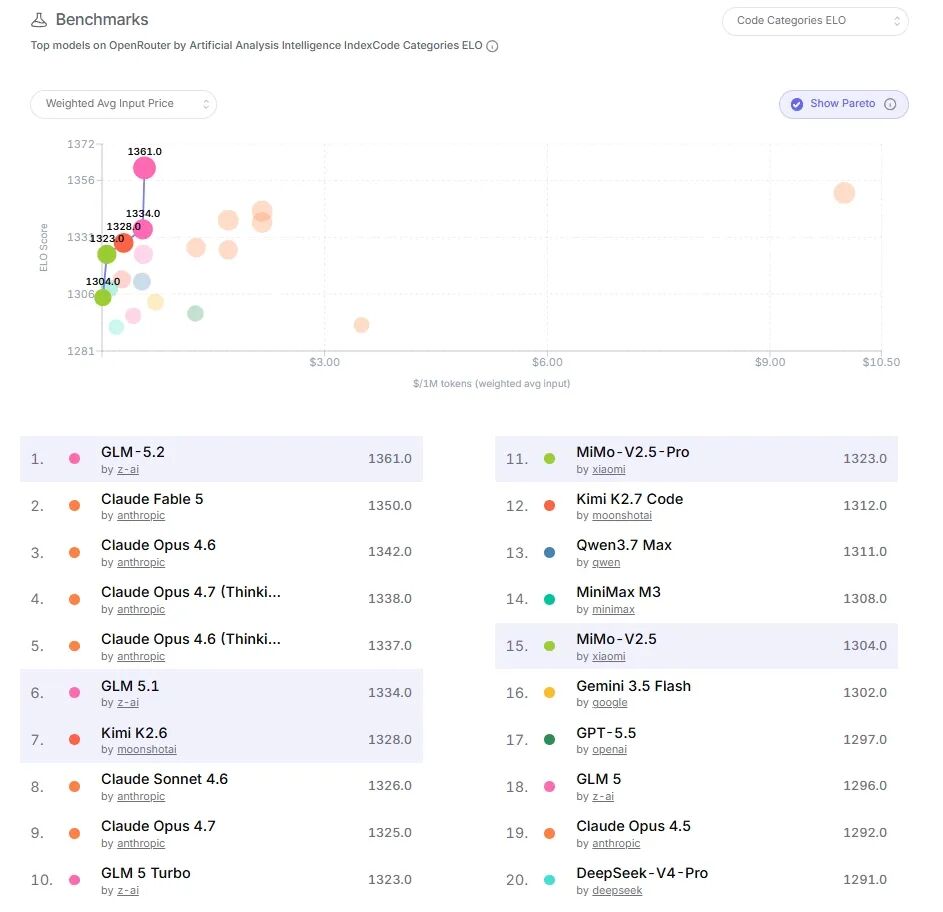
Design Arena 的 Code Categories ELO(对战积分)榜:智谱开源 GLM-5.2 以 1361 分 登顶,击败 Claude Fable 5(1350,已于 2026-06-23 被 OpenRouter 下架不可调用)、Claude Opus 4.6(1342)、Claude Opus 4.7 Thinking(1338)。在所有当前可用的模型里,GLM-5.2 是 无可争议的第一。
ELO 评分机制:模型两两对战,由人类盲评判定胜负,积分越高代表"实际表现越被认可"。这比 benchmark 跑分更能反映真实使用体验。
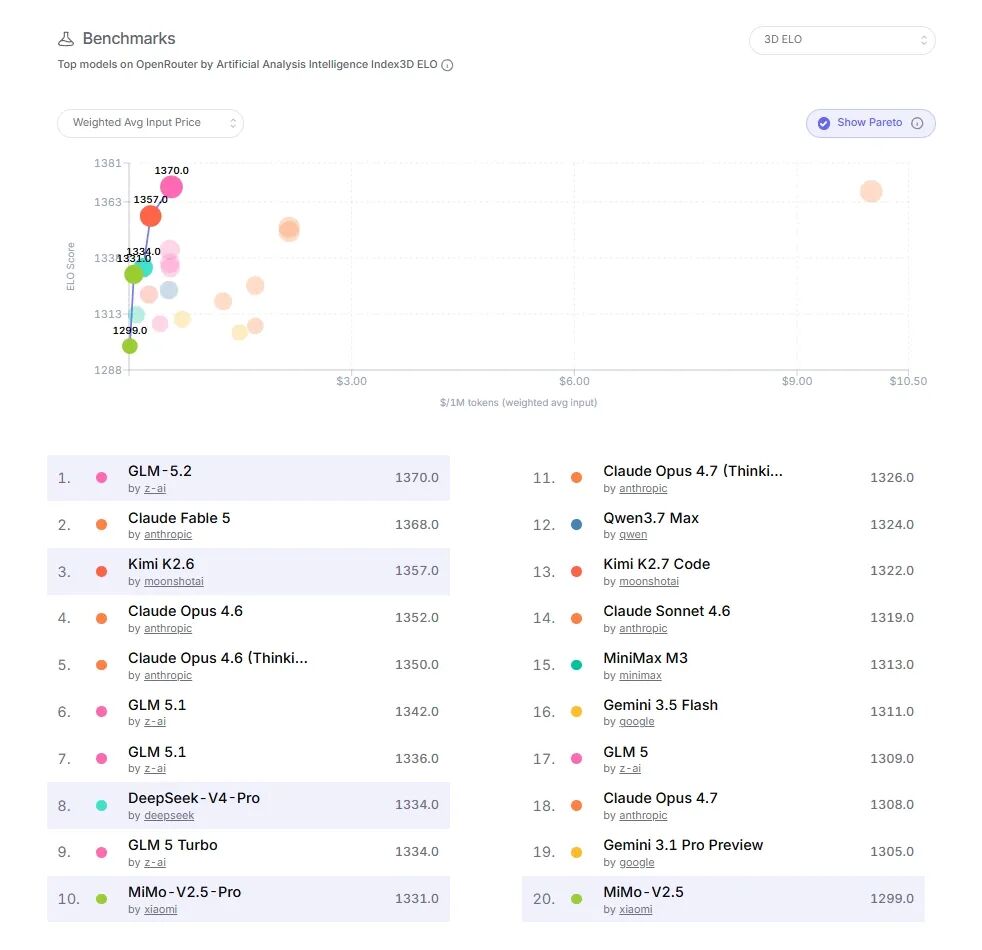
3D ELO 榜:GLM-5.2 1370 分 再次登顶,把 Anthropic Claude Fable 5(1368,已下架)压到第二,差距 18 分。Kimi K2.6 排第三 1357。在可用模型里 GLM-5.2 同样 稳坐第一。3D ELO 是国产开源模型领先优势最大的领域。
GLM-5.2 在 Code / 3D / Game / UI / DataViz 五个 ELO 维度的综合表现,原本 UI 榜首是 Claude Fable 5(已下架不可用),其他四项全在前二。Claude Fable 5 2026-06-23 被 OpenRouter 禁用后,GLM-5.2 在 Code / 3D / Game / UI / DataViz 五个维度全部登顶可用模型第一。智谱这一轮开源真的打出了名堂。
关键修正(2026-06-23):原本位列 UI / 3D / Code 三榜前列的 Anthropic Claude Fable 5,已 于 2026-06-23 被 OpenRouter 下架(疑似许可证问题或安全审核),现不可调用。扣掉 Claude Fable 5 之后,GLM-5.2 在所有可用模型里直接登顶第一——这意味着 5 大榜里,GLM-5.2 拿下"开源 / 闭源 / 可用 / 不可用"四个维度中的"开源 + 可用"双料冠军。
六、市场份额:中国系合计约 48%
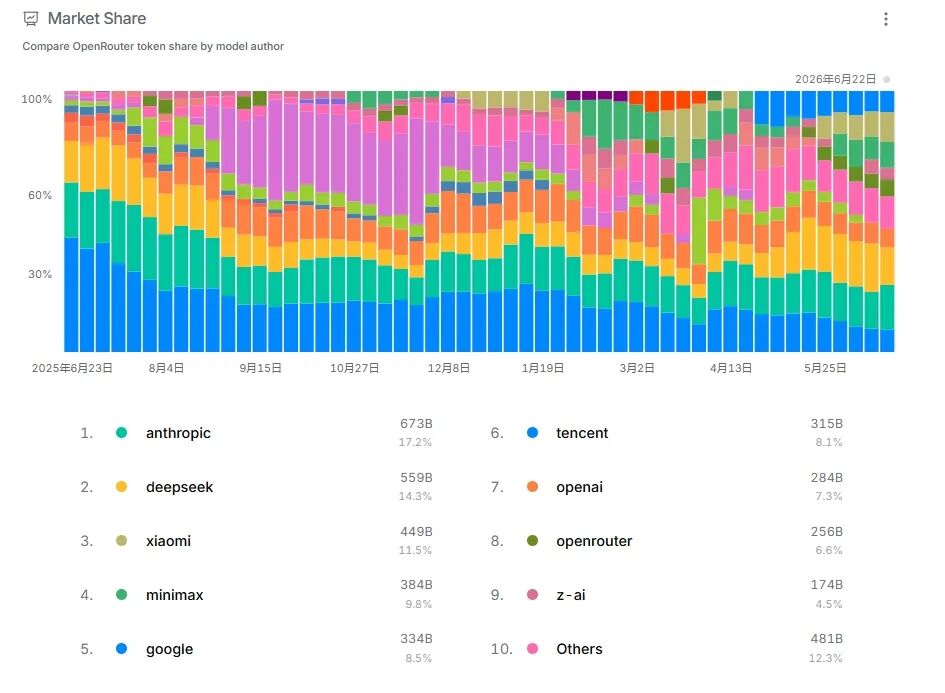
按模型作者统计的当日市场份额:Anthropic 17.2% 第一,DeepSeek 14.3% 第二,小米 11.5% 第三,MiniMax 9.8% 第四,Google 8.5% 第五。
中国系(DeepSeek + 小米 + MiniMax + 腾讯 + 智谱)合计约 48.2%,已经接近半壁江山。美系(Anthropic + Google + OpenAI)合计 33%。一年前这个比例还是反过来的。
七、美系 LLM 还剩哪些阵地
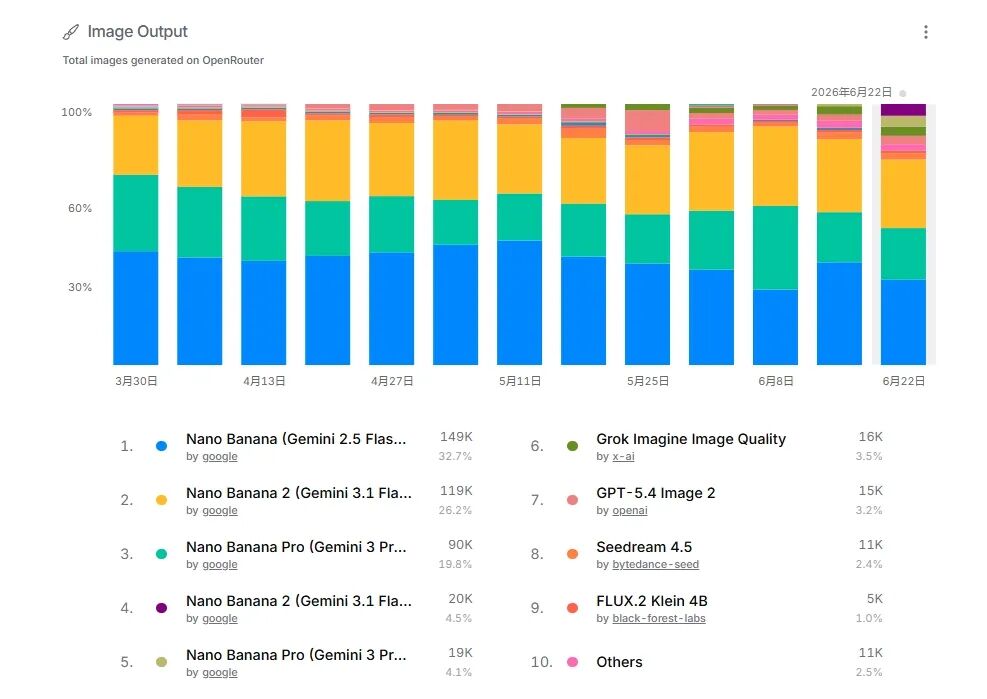
别以为中国 LLM 已经全面碾压——图片生成是最大短板。Google Nano Banana 系列(前 5 全是 Gemini 改装)合计 87.3%,一款 Gemini 2.5 Flash 改装吃下 32.7%。
国产仅字节 Seedream 4.5 占 2.4% 排第八,Anthropic 的 GPT-Image-1 都没进前 3(前 9 里 6 个 Gemini)。这是中国 LLM 最痛的短板,做图像生成需求,老实上 Gemini。
智能指数和 UI 组件是 Anthropic Claude Fable 5 的强项,分别拿到 59.9 分和 1414 ELO。但这些是综合能力维度,不是用户最常调用的编程场景。
八、速度榜:Cerebras 694 tok/s 第一
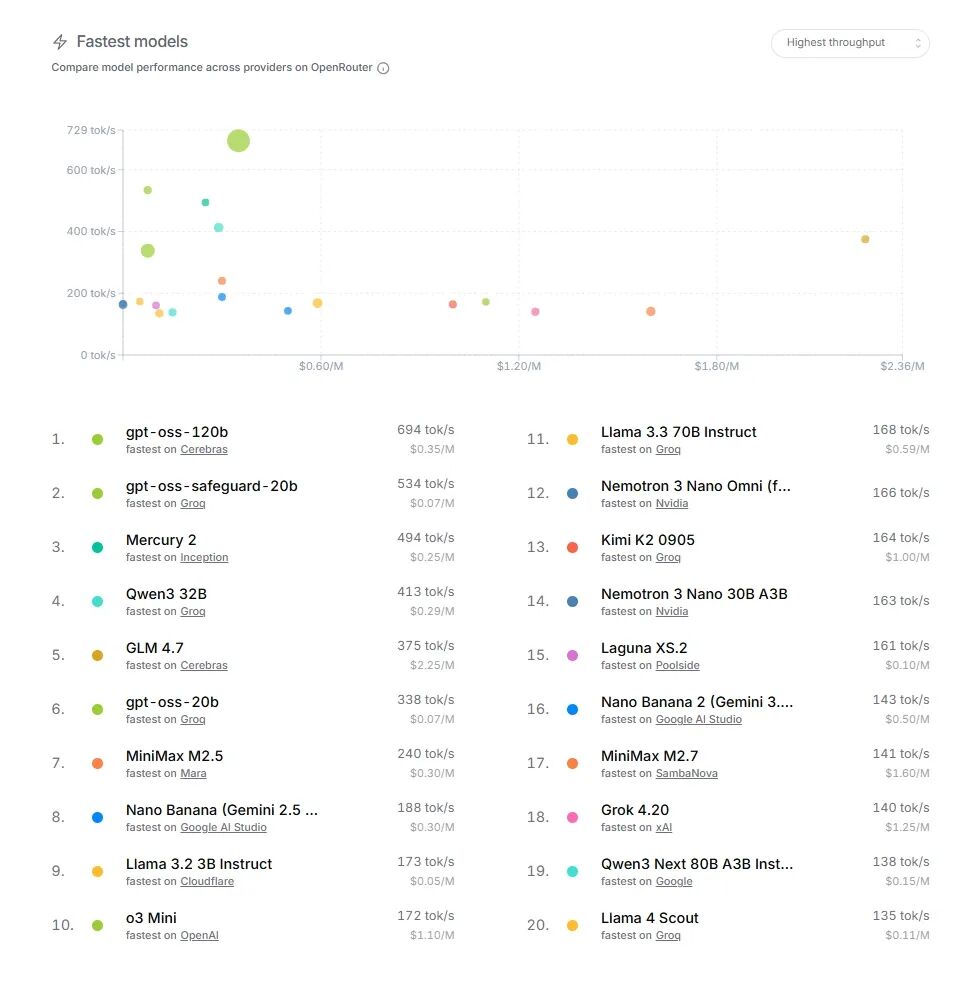
速度榜是另一个独立维度。Cerebras 晶圆级加速卡跑 gpt-oss-120b 694 tok/s 第一,Groq 跑 gpt-oss-safeguard-20b 534 tok/s 第二。Groq 阵营在前 20 占 6 席,是当之无愧的速度之王。
国产模型在速度榜表现:Qwen3 32B 跑在 Groq 上 413 tok/s 第四,GLM 4.7 跑在 Cerebras 上 375 tok/s 第五。延迟榜上 DeepInfra 阵营占 5 席,最低 150ms。
速度榜单看 GPU 硬件选型,不直接反映模型质量。但实际使用中,速度快的模型 + 便宜的价格 = 用户最爱用,间接推动月榜排名。
九、按读者情况分流
如果你是国内开发者
直接装 DeepSeek V4 Flash(编程 4.8% 份额)+ MiniMax M3(编程 12%)+ GLM-5.2(Code ELO 1361 登顶)三件套,覆盖 80% 编程场景。
如果你是出海 / 英文场景
DeepSeek V4 Flash 英文使用量 791B 第一,混元 411B 第二,闭源选 Claude Sonnet 4.6(306B)。
如果你是做图片生成
老实上 Google Gemini 2.5 Flash(图片生成 32.7%),国产目前真没一个能打的。
如果你还没装 coding agent
OpenRouter Top Apps 月榜前 4 全是 coding agent: Hermes Agent 22T 第一 (周 6.49T + 日 911B 全时段第一), Kilo Code 5.98T 第二, OpenClaw 5.07T 第三 (开源), Claude Code 2.88T 第四 (Anthropic 官方, 是 Hermes 的 1/8)。前 3 全开源, Hermes 真的能打。
如果你是企业 / 学术场景
编程选 GLM-5.2(智谱)+ MiniMax M3,长文档选 MiMo + MiniMax 双开,图像暂时绕道 Gemini API。
十、质变都是从量变开始的
前面九个角度都是"量变"——月榜 4 席全国产 (53.3T tokens / 月), 编程 Top 3 全国产 (41.5%), 长上下文 Top 2 全国产 (33.5%), 中国系市场份额 48.2%。这些数字一年前还都是 Anthropic / Google / OpenAI 的主场。
但真正让我觉得"质变已经到了"的, 是这三个信号:
信号 1 / GLM-5.2 三榜登顶: Design Arena 的 Code Categories ELO 1361 分击败 Claude Fable 5 (1350), 3D ELO 1370 分击败 Claude Fable 5 (1368), Coding Index 68.8 国产开源最强。在 Code / 3D / Game / DataViz 五个 ELO 维度, GLM-5.2 拿了 4 项前 2 (UI 让给 Claude Fable 5)。智谱开源模型在 benchmark 跑分 + ELO 人类盲评两边都压过闭源旗舰。
信号 2 / 智谱港股 6-22 破万亿港元: 日内涨幅 40%, 年内累计涨 1900%, 1-8 上市发行价 116.2 港元, 6-22 盘中最高 2980 港元 (涨近 20 倍)。GLM-5.2 6-17 发布当天智谱港股 +12.62%, 技术 → 资本闭环跑通了。
信号 3 / 马斯克对话唐杰: 马斯克 X 平台: "GLM-5.2 无疑缩短了差距, 预计中国或于 2027 一季度追上顶尖水平"; 智谱 AI 创始人唐杰回应: "用不了这么久"。全球科技领袖亲自下场定调, 中国 LLM 不再是追赶者。
量变 → 质变 的逻辑: OpenRouter 月榜 + 编程用途 + 长上下文 + 市场份额 4 个量变, 是中国 LLM 真实使用量的"基本面"; GLM-5.2 三冠 + 智谱港股万亿 + 马斯克背书 3 个质变, 是从"用得多"到"被认可"的跨越。一年前只能谈"市场份额", 现在可以谈"技术 + 资本 + 评价"三位一体的领先。
回到开头那个问题:5 大榜,中国 LLM 拿了几项第一?
月榜 Top 4 全国产 / 编程用途 Top 3 全国产 / Code ELO 登顶 / 3D ELO 登顶 / Top Apps 国产开源占 2 席(Hermes Agent + OpenClaw)。5 项拿了 5 项第一。
我一开始以为国产 LLM 是追赶者,看完 27 张数据图才发现——在 OpenRouter 这个全球 API 市场上,它们已经是领跑者了。
十一、引申阅读
数据来源:openrouter.ai/rankings(2026-06-22 截取,27 张截图完整数据)
统计口径:tokens = OpenRouter API 调用产生的 token 总数(含 prompt + completion)
数据局限:OpenRouter 是聚合平台,原始流量来自终端应用,不直接等同于"最终用户使用量"
如果你觉得这篇文章有用
欢迎关注公众号「丁卯生人」
专注 AI 工具与开源项目深度评测
每次更新第一时间推送给你
六六爸比(本文作者,85后科技IT爱好者),本文首发于公众号「丁卯生人」。
如果这篇文章对你有帮助,欢迎点上面那张名片关注公众号「丁卯生人」,收到新文章会第一时间推送。