4.6 万星的 skill 只改一件事:AI 回答的第一行,必须是你现在就能做的动作
大家好我是六六爸比,一个 85 后科技 IT 爱好者。
问 AI 一个 bug,它回你一大段:先夸你问题问得好,再复述一遍项目结构,然后说"有几个可能的方向",答案埋在第三段中间,最后祝你愉快。
你其实只想要一行:跑哪条命令,改哪个文件第几行。
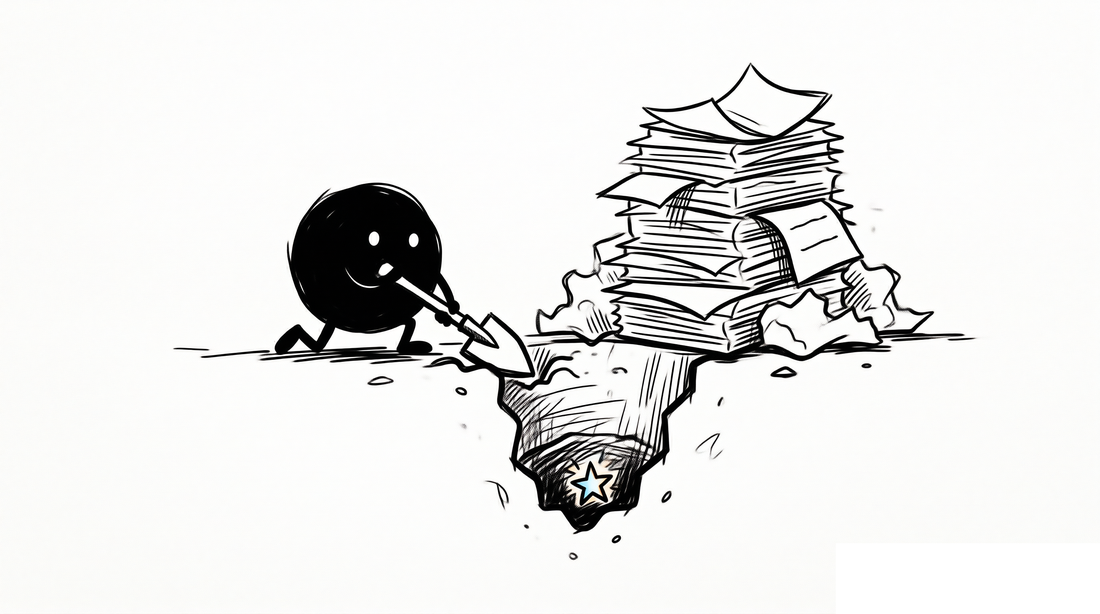
▲ 你要的答案一直在,只是被埋在第三段下面
这周 GitHub Trending 周榜第一,是个专门治这个毛病的仓库 ayghri/i-have-adhd,周增 +17,658 星,总星 45,979。它的全名很直白——"A skill to stop your coding agent from burying the answer",一个让编程 agent 别把答案埋起来的技能。
一、它就是一个 7 KB 的文本文件
先说清楚体量:整个仓库 0.33 MB,核心是 skills/i-have-adhd/SKILL.md,7 KB。没有服务,没有依赖,没有模型。
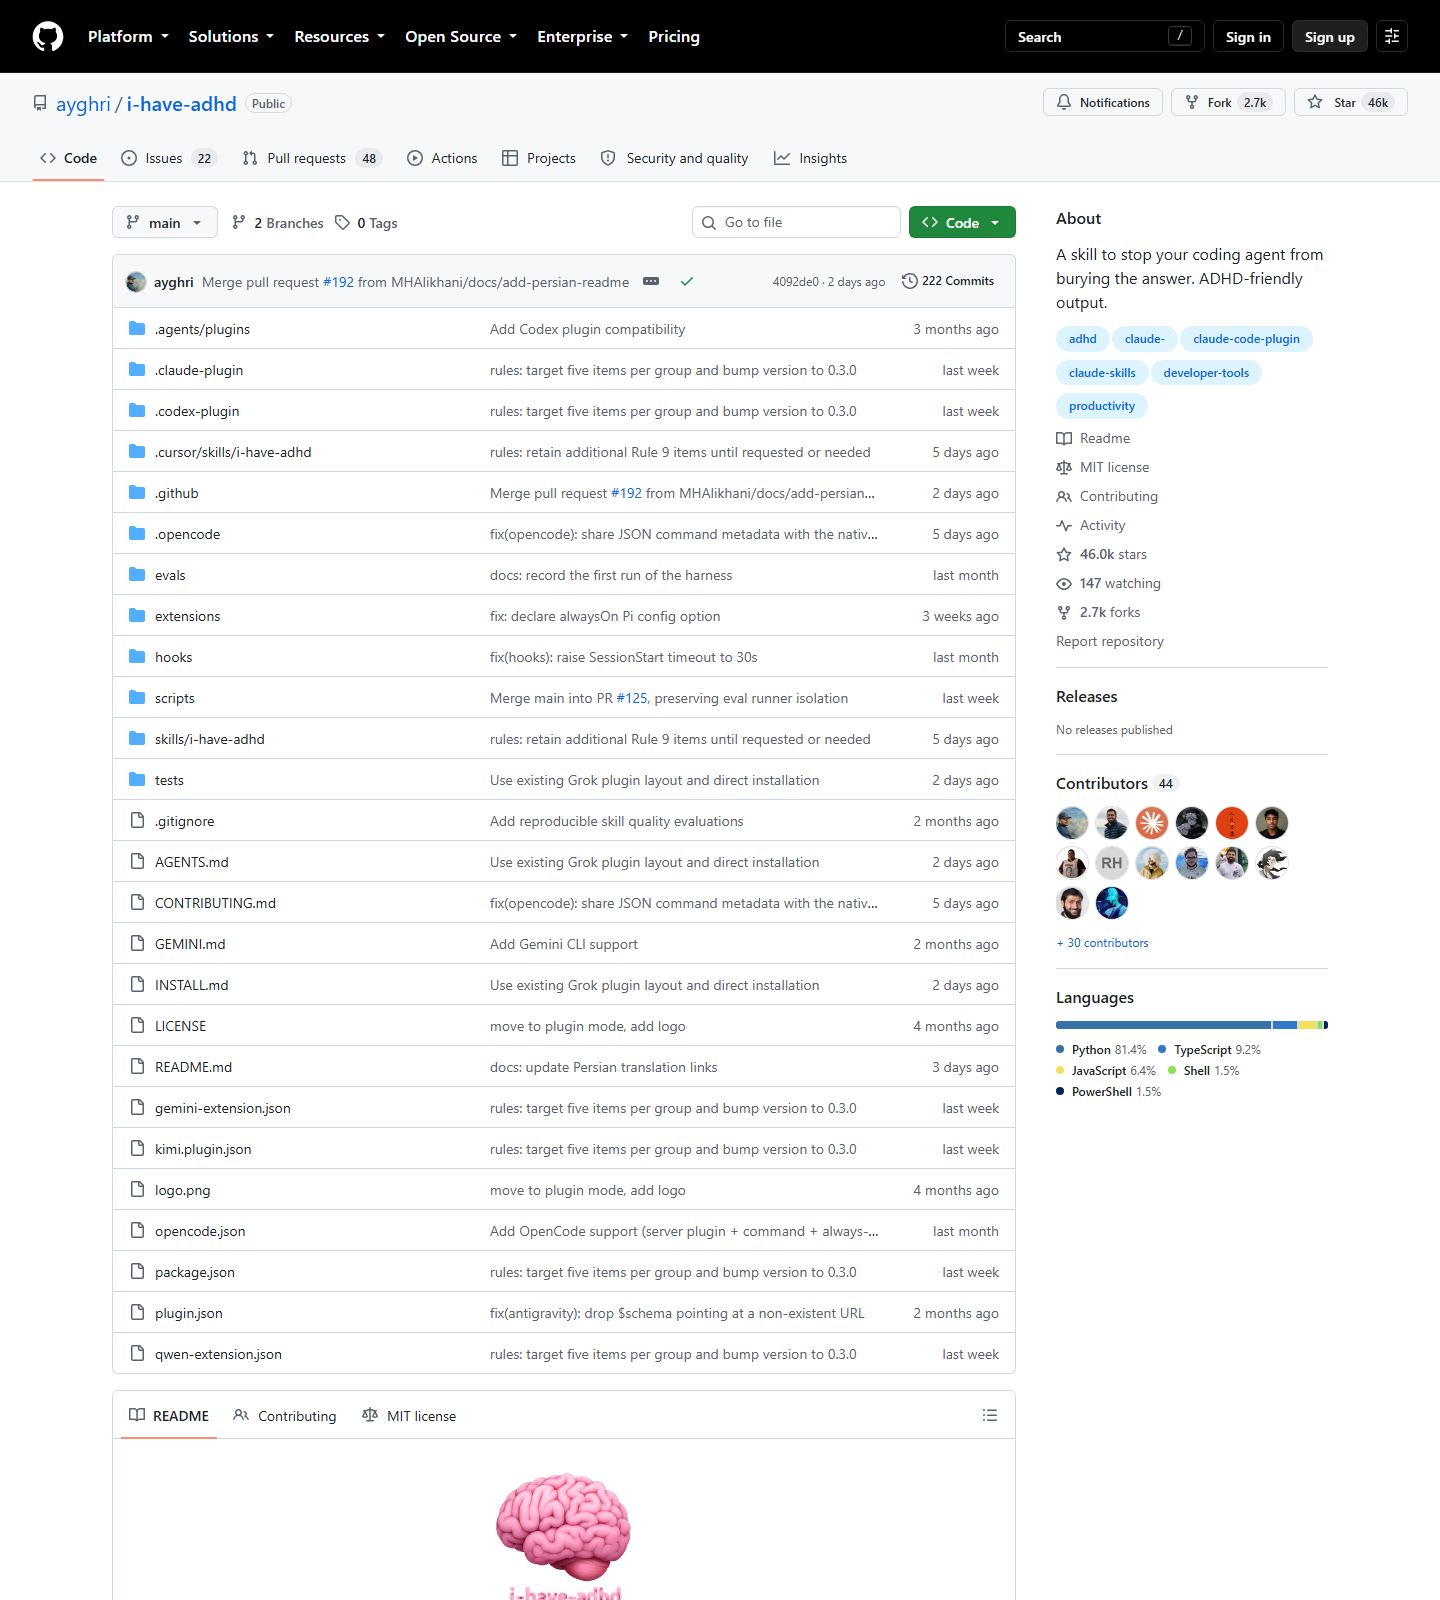
▲ 仓库首页实拍:46.0k stars、2.7k forks、44 位贡献者,文件树里能看到 evals/ 和各 agent 的插件目录
README 里那张 Before / After 对照,是全文最有说服力的部分:
改之前——
Great question! Let me think about this. Your auth flow has a few moving pieces: the middleware, the token verification, and the cookie handling. Looking atsrc/auth.ts, theverifyTokenfunction (around lines 42-58) seems to be using an olderjsonwebtokenAPI. One approach would be to update the package and rewrite that function. After making the change, you'd want to run the auth tests to confirm nothing breaks. By the way, you might also want to look at your dependency versions overall. Hope this helps! Let me know if you want to dig deeper.
改之后——
Runnpm install jsonwebtoken@latest, then editsrc/auth.ts:42.<br>1. Opensrc/auth.ts<br>2. ReplaceverifyToken(lines 42–58) with the snippet below<br>3. Runnpm test -- auth.spec.ts<br>Next: paste the first failing line if any test fails.
同一件事,字数少一半,第一行就能动手。
这段中文语境你肯定熟——"这是个好问题!""让我们来分析一下""希望这能帮到你!"。我自己写稿也定过一条规矩:这类模板腔一次都不许出现。这个 skill 干的就是把 AI 侧的这类话删掉。
二、10 条规则,背后是 5 个事实
规则本身不复杂,全文在 SKILL.md 里:
• 以下一个动作开头,不是背景也不是计划
• 多步骤任务必须编号
• 结尾留一个具体的下一步
• 压制跑题
• 每一轮重述当前状态
• 时间估计要具体(说"12 分钟",不说"要一阵子")
• 让进展可见
• 报错要平铺直叙,不要戏剧化
• 列表最多 5 条
• 没有开场白、没有回顾、没有收尾语
真正让我觉得这仓库不是玩票的,是它前面那段 "ADHD 改变了阅读的哪五件事"——每条规则都能追溯到这儿:工作记忆装不下,所以屏幕上没有的就是忘了;知道答案不等于去做了,"懂了"和"做了"之间才是工作死掉的地方;启动是最难的一步,所以第一个动作必须小、明显、现在就能做;时间估计在 ADHD 眼里是均匀模糊的;多巴胺稀缺,所以看得见的进展很重要。
也就是说,它不是"把话写短点"这种笼统要求,而是围绕一个具体的认知障碍,把输出格式重新设计了一遍。名字是个玩笑,底下是有出处的——README 致谢里写了,规则松散地参考了《The Adult ADHD Tool Kit》。
三、硬货在这:它自带评测,还公开写着自己没过闸
这是我真正想写这一段的原因。仓库里有个 evals/ 目录,跑过一轮打分,结果写在 evals/RESULTS.md:
14 个用例、每例 3 次、两个条件共 84 条记录,盲评,判分用同一个模型。花了 $2.67 生成 + $0.92 判分。
作者自己的结论只有一句:每个维度都涨了,包括权重最高、也最容易被风格改动拖累的正确性和安全性——这个 skill 没有拿准确换简短。
但接下来这段才是我服气的地方。同一份文件下面写着:
Release gate: FAILED(发版门禁:未通过)
原因是门禁里有一条"不得存在 blocking 问题",而加了这个 skill 的回答里仍有 3 个 blocking(基线是 7 个)。规则是绝对的,所以哪怕把阻断数砍掉一半多,仍然判失败。作者还顺手补了一句:其中两个 blocking 来自一个"任何模型都过不了"的用例;就算把它剔掉,基线 5、候选 1,门禁照样失败——同一条规则。最后写的是:这个性质值得主动决定,而不是发版时才发现。
一个涨到 4.6 万星的仓库,在自己文档里写着"我们的评测没过我们自己的闸",还解释了为什么会这样。这比任何"效果显著提升"的措辞都可信。
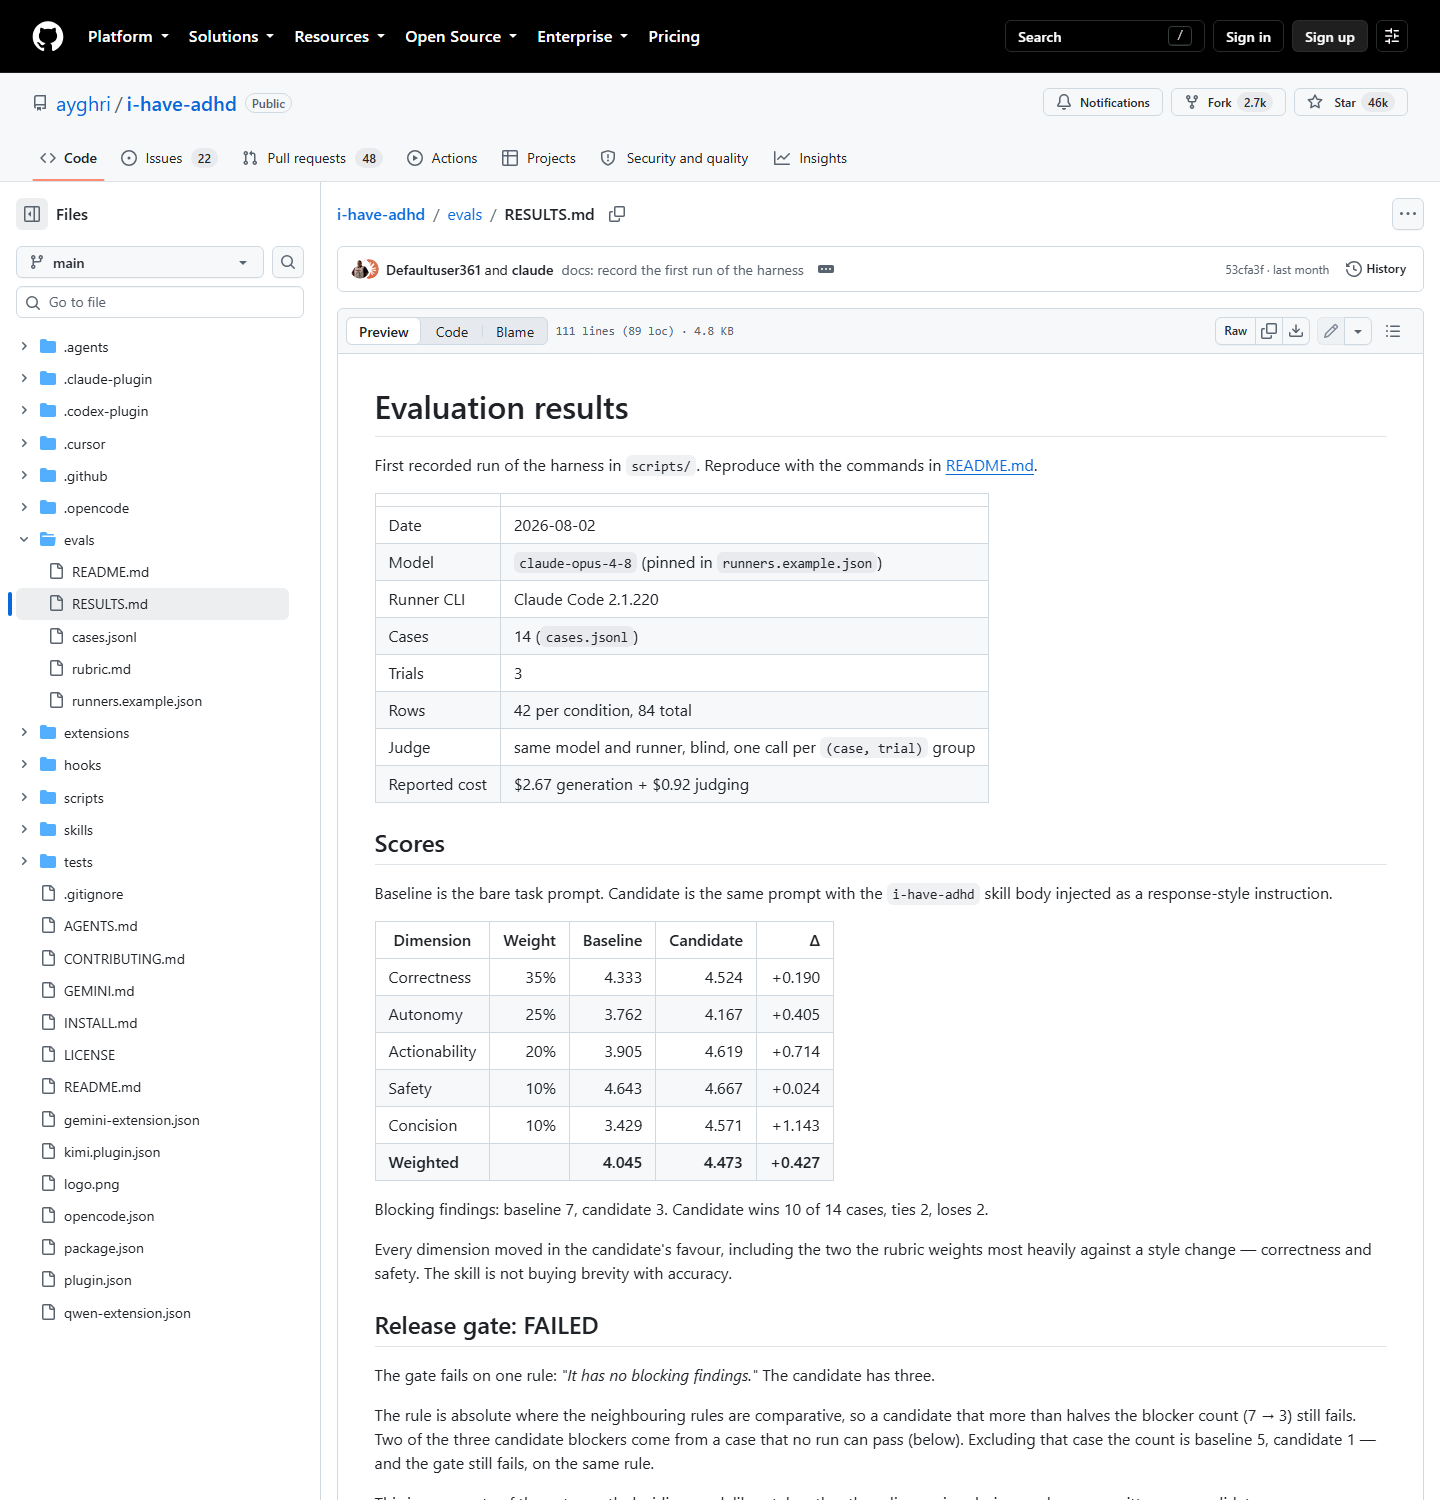
▲ evals/RESULTS.md 实拍:分数表下方就是那句 Release gate: FAILED
分用例看更有意思:multi-step-progress 从 2.23 涨到 4.77,error-report 从 2.07 涨到 4.47——多步骤任务和报错场景提升最大;而 direct-answer 4.97→5.00、complex-plan 4.58→4.60 几乎没动。它只在需要的地方起作用,没有为了简短把本来就该展开的内容砍掉。
四、怎么装,以及它覆盖了多少 agent
安装方式懒人版:把这句丢进你的命令行提示符——
Install the i-have-adhd skill/plugin from https://github.com/ayghri/i-have-adhd, refer to the repo's AGENTS.md for instructions.
仓库里连 AGENTS.md 都是写给 agent 看的安装说明,这设计挺聪明。
覆盖的宿主是我没想到的广:Claude Code(.claude-plugin)、Codex(.codex-plugin)、Cursor(.cursor/skills)、OpenCode(插件 + command)、Gemini(extension + agent toml)、Kimi、Qwen、Pi,还有 marketplace.json。一个 7 KB 的 SKILL.md,八家 agent 全都能加载——Agent Skills 这套开放格式能推到这个程度,这个仓库本身就是个例子。
用法上有两个细节要留意:
• 它的 frontmatter 里有 disable-model-invocation: true——模型不能自己决定启用它,必须你手动 /i-have-adhd 调起。这条设计是对的,输出风格这种事不该由模型替你决定。
• 调起后会在整个会话里持续生效,直到你说 stop adhd mode 或 normal mode 才关掉,且它会一行确认再切回默认风格。
五、三条提醒
• ① 它是会话级开关,不是局部修饰。 一旦开了,之后所有回答都被这套格式约束。你要 AI 展开讲一个概念、写一份长文档时,记得先关掉——评测里 long-form-request 这一项分数没变(4.90→4.90),说明它设计上不牺牲长文,但格式约束是全局的,别拿它当无副作用的开关。
② 评测的覆盖面很窄,别当普适结论。 只测了一个模型(claude-opus-4-8)、一个 runner(Claude Code 2.1.220)、14 个用例、3 次重复。换模型、换 agent 宿主,效果不会自动一样。作者也是这么标的,不是隐瞒。
③ 它治格式,不治内容。 答案对不对、方案好不好,跟这 10 条规则无关。格式变清爽之后,一个错答案会显得更有说服力——这反而更危险,该核的还是得核。
另外中文场景你得自己改:规则里的"Hope this helps!"这类是英文语境的口头禅,中文 AI 腔是另一套("首先""综上所述""值得注意的是""希望对你有帮助")。这仓库留了口子——fork 改 SKILL.md 换上你自己的那份就行。我自己那套 AI 腔红线,正好可以喂进去。
我的判断
这仓库值得学的不是那 10 条规则——规则你今晚就能自己写出来,甚至更合你的口味。
值得学的是给一个 prompt 包写评测这件事。evals/ 里有用例集、有评分细则、有判分脚本、有成本记录,还有公开写着的失败结论。现在 Agent Skills 这一层正在快速膨胀,一个 SKILL.md 好不好,以前只能靠作者的截图和你的直觉。有了 evals/ 目录,才第一次有了可复现的说法。
会不会给自己的 skill 写评测、敢不敢把 FAILED 写在文档里,我认为是 2026 年区分玩具和工具的一道线。
仓库放这儿,两分钟能装完,今晚就能试:github.com/ayghri/i-have-adhd
数据来源:仓库元数据与全部文件清单取自 GitHub API 2026-09-15 实时(45,979 星 / 2,675 fork / 70 open issue / 建库 2025-05-13 / 最后提交 2026-09-14 / MIT / 仓库 0.33 MB);周增 +17,658 来自 GitHub Trending 周榜(2026-09-15 抓取);Before/After 对照、10 条规则、5 条 ADHD 事实、致谢出处均出自 README.md 与 skills/i-have-adhd/SKILL.md 原文;评测数据全部出自 evals/RESULTS.md(2026-08-02 那轮,模型 claude-opus-4-8,14 用例 × 3 trial);两张页面截图为本文 headless 抓取。细节以仓库当前版本为准。
—— 六六爸比 · 一个 85 后科技 IT 爱好者
今晚就试一下。装完随手问它一个 bug,看第一行是不是你马上能跑的命令。不合适就关掉,成本是两分钟。
与君共勉:
1. AI 是打破信息茧房的利器。是我们追求信息平等的手段。
2. 警惕上来就忽悠你学各种所谓高大上的工具 Agent, 让你买教程的。
3. AI 时代你只要懂逻辑, 懂中文, 独立思考能力! 一定会有所作为!
4. 与君共勉, 与君一道踏破这 AI 门槛, 让 AI 真正为你所用!
留言区聊聊:你被 AI 的哪句开场白恶心到过?
① 2026-09-05 · 清华把一间教室,开源给了所有 AI:OpenMAIC 拆解
② 2026-08-20 · 当 Model 决定上限、Harness 决定下限:DeepSeek 正在重写 AI Agent 的规则
③ 2026-08-12 · AI 时代的旅行:5 个 SKILL.md 跨 WorkBuddy/Coze/Dify 复用
④ 2026-08-05 · FFmpeg 9.0 代号 Lei 正式发布
⑤ 2026-08-01 · Reasonix 1.x 正式版:0.x → 1.x 一年磨一剑
⑥ 2026-07-31 · Hermes Skill 官方榜单 · 2026.07 完整数据复盘
⑦ 2026-07-30 · OpenRouter 7 月复盘:4 平行宇宙 + 4 中国黑马
⑧ 2026-07-23 · Hermes 4 月模型榜:9 大发布速览
六六爸比
一个 85 后科技 IT 爱好者, 公众号「丁卯生人」主理人
每周分享 AI 工具 / 大模型 / 内容创作 / 个人成长