AI大模型百科: 互联网黑话一次讲清
大家好我是六六爸比,一个 85 后科技 IT 爱好者。
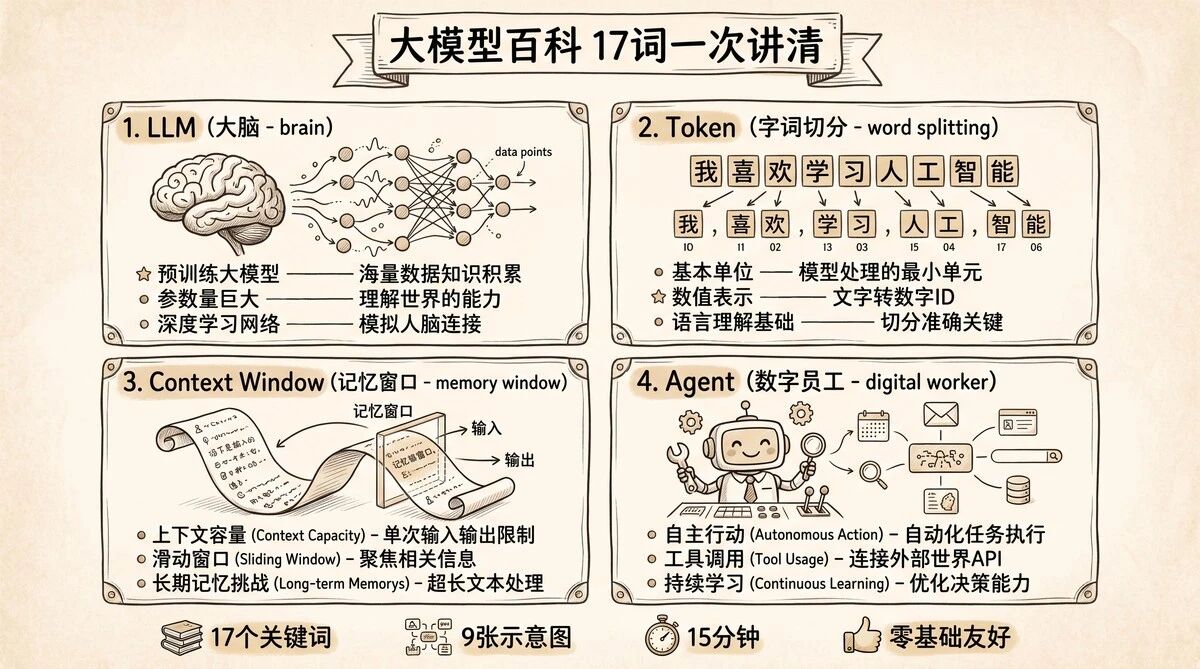
写给"被同事一嘴黑话砸晕、老板群里蹦英文词、朋友圈刷 AI 视频但讲不清原理"的你。17 个互联网 AI 黑话一次讲清, 9 张手绘信息图。
1什么是大模型(LLM)
Large Language Model · 大语言模型
大模型本质上是一个会"接话茬"的程序。你给它上半句,它就猜下半句该说什么。它不是真的"懂"你说的话,它是在海量文本里学到了"什么词后面大概率跟什么词",从而能像人一样组织语言。
所谓"大",体现在三件事上:训练数据大(喂了几乎整个互联网)、模型参数大(参数量动辄几百亿到几万亿)、算力消耗大(训练一次的成本能买下几栋楼)。
2Token:按"字"卖菜的最小单位
Token · 模型"切词"收费的最小单位
模型不直接看"字",它看的是 Token。Token 可以理解成"模型自己切出来的小块",一个中文汉字通常对应 1\~2 个 Token,一个英文单词通常对应 1\~4 个 Token。
所有调用 API 的费用,几乎都是按"输入了多少 Token + 输出多少 Token"来算的。所以"Token"这个词你会在账单里反复看到。
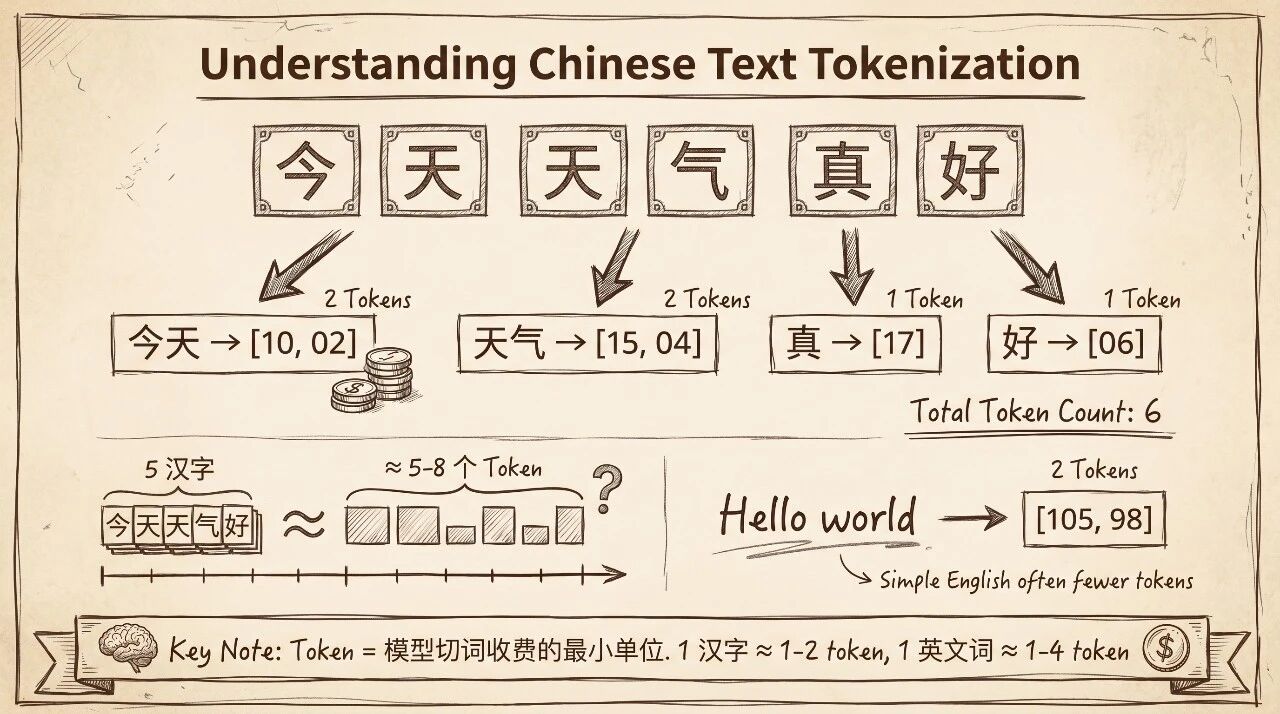
图 4:Token 切词示意
3上下文窗口:模型的工作记忆
Context Window · 一次能"记"多长上下文窗口就是模型一次对话里最多能"装下"多少内容。超过这个长度,模型就会"忘记"最早的内容。
2026 年的主流模型,上下文窗口已经从 4K(够读几页)、32K(够读一本书)、200K(够塞进一份财报),卷到了 1M\~10M Token(够塞一整年聊天记录)。
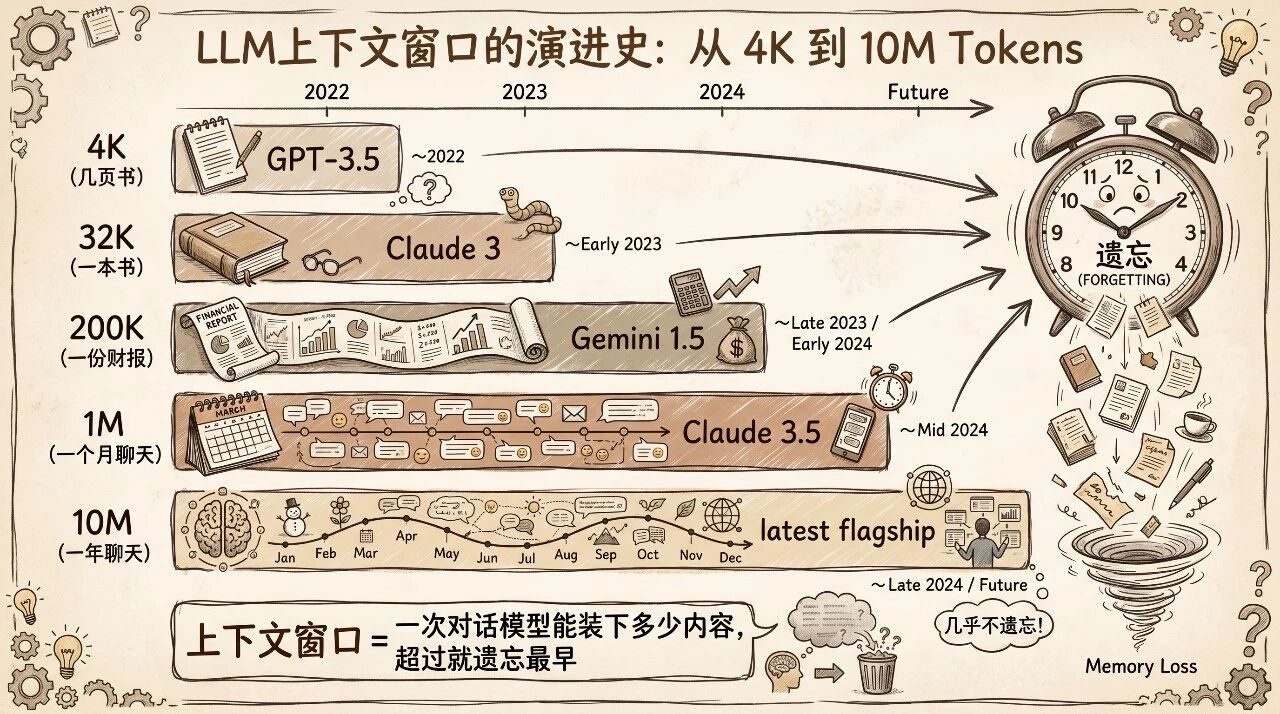
图 5:上下文窗口的进化
4大模型的参数:大脑的"神经元数"
Parameters · 模型里"可以调"的小旋钮参数是模型内部"可以调节的数值",你可以理解成模型大脑里的"神经元连接强度"。一个模型有几亿、几千亿、几万亿个这样的连接强度,它们共同决定了模型"会不会说话"、"说话有多溜"。
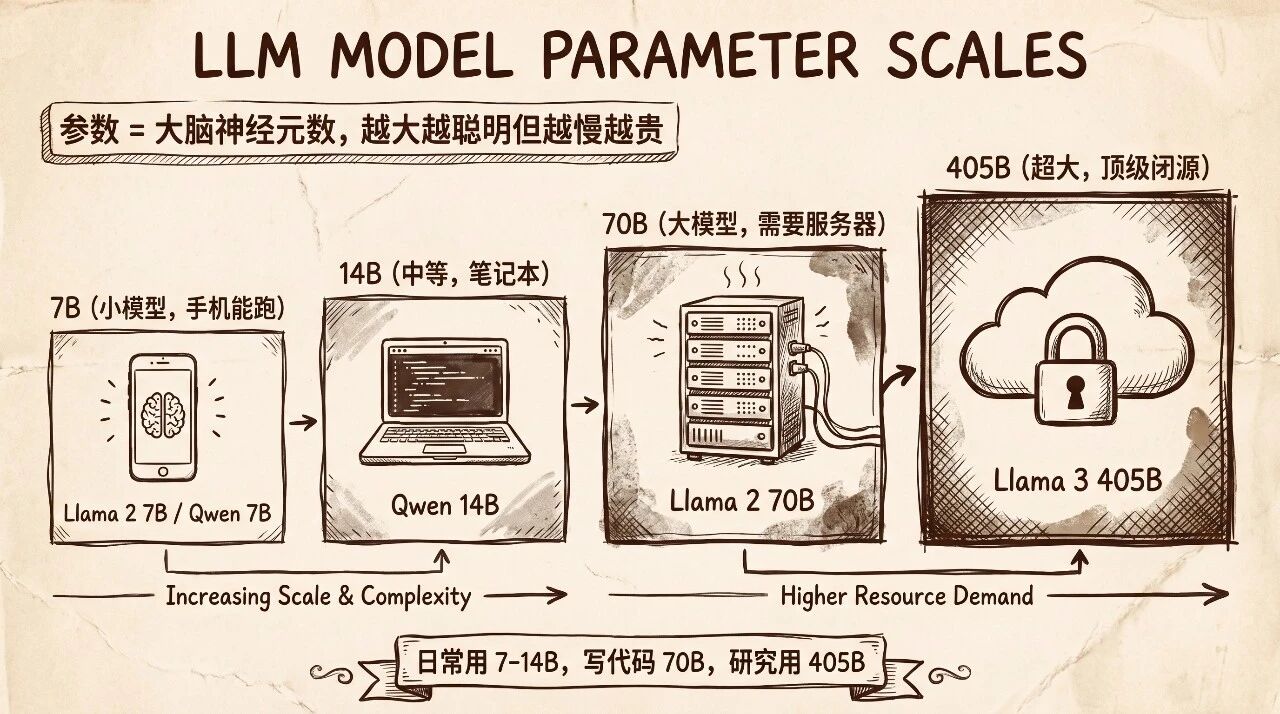
图 6:模型参数量级对比
所以你常看到的"7B、70B、405B",B 是 Billion(十亿),这些数字就是参数量。一般而言,参数越大,模型越聪明,但也越慢、越贵、越难部署。
5训练机制四件套:预训练 / 微调 / RLHF / 蒸馏
Pre-training / Fine-tuning / RLHF / Distillation模型不是"一次训练完"就完事的,它要经历几道工序:
① 预训练(Pre-training)
把海量文本(书、网页、代码、新闻……)一股脑喂给模型,让它学"语言的规律"。这一步是最贵、最慢、最吃算力的,可能要花几千万美元和几周时间。预训练完的模型叫基座模型(Base Model),它会说话,但还很粗野、不知道什么该说什么不该说。
② 微调(Fine-tuning)
在基座模型上,用特定领域的数据再"培训"一轮。比如让它学医、懂法律、懂你公司的产品手册。微调成本远低于预训练,而且能让模型"专精"某一行。
③ RLHF(人类反馈强化学习)
让人来给模型的回答"打分",答得好的加分、答得离谱的扣分,模型就慢慢学会了"什么回答人类更喜欢"。ChatGPT 之所以"说话像人",靠的就是这一招。
④ 蒸馏(Distillation)
让一个"小模型"去模仿一个"大模型"的输出,把大模型的本事"压缩"进小模型里。结果是:小模型跑得快、便宜,但能力比大模型略弱,很适合手机、嵌入式设备。
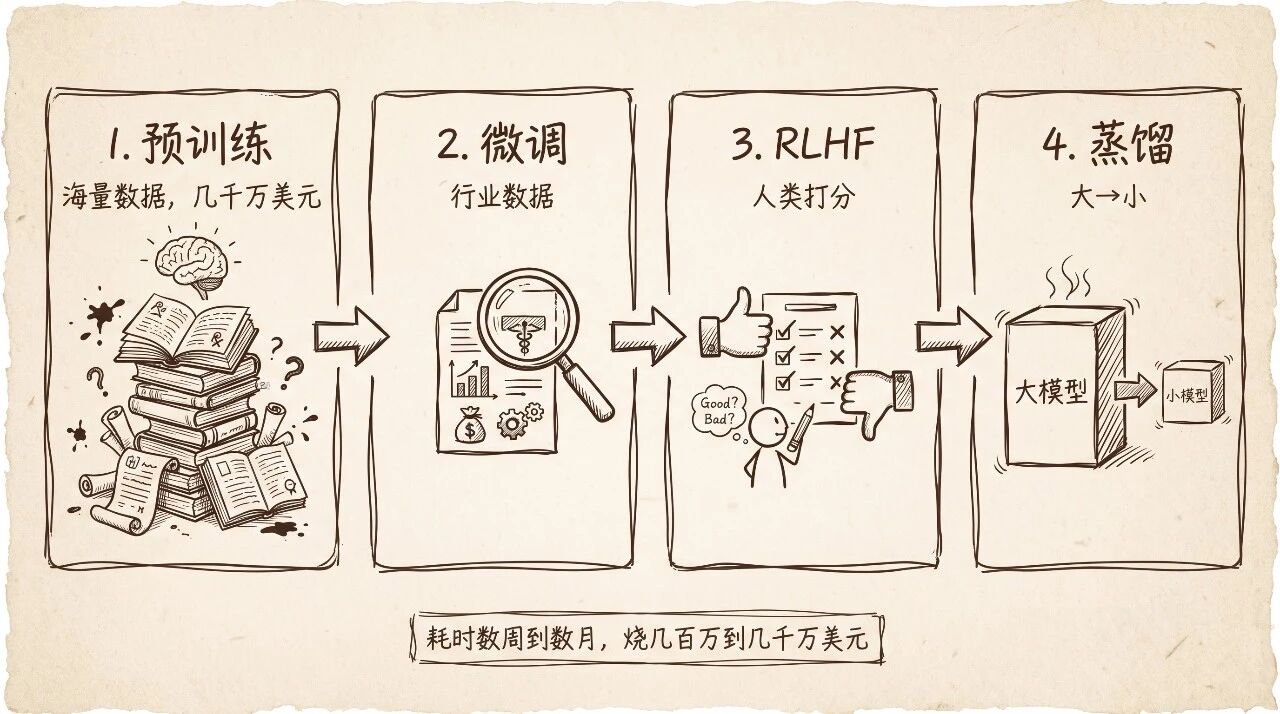
图 1:训练四件套,基座模型是怎么一步步变成 ChatGPT 这种"人话助手"的
6大模型的 API:和模型说话的标准方式
Application Programming Interface · 应用程序编程接口API 就是"让别的程序能调用大模型的标准通道"。普通用户用 ChatGPT 是打开网页聊天;开发者要用模型处理业务,就要走 API,用代码发请求,模型回结果,全程自动化。
常见的 API 形态:发一段文字(prompt),拿到模型生成的回复(completion),全程按 Token 收费。
client.messages.create(model="claude-opus-4.7", messages=[{"role":"user","content":"帮我写一封请假邮件"}])返回的就是模型生成好的请假邮件文字。开发一个智能客服、AI 助手、自动写文案的工具,全靠这种调用。
7部署形态:开源 vs 闭源、本地 vs 云端
Open Source vs Closed Source · Local vs Cloud选大模型不只是"选哪个最强",还要看你怎么用。两个维度的选择交叉出四种形态:
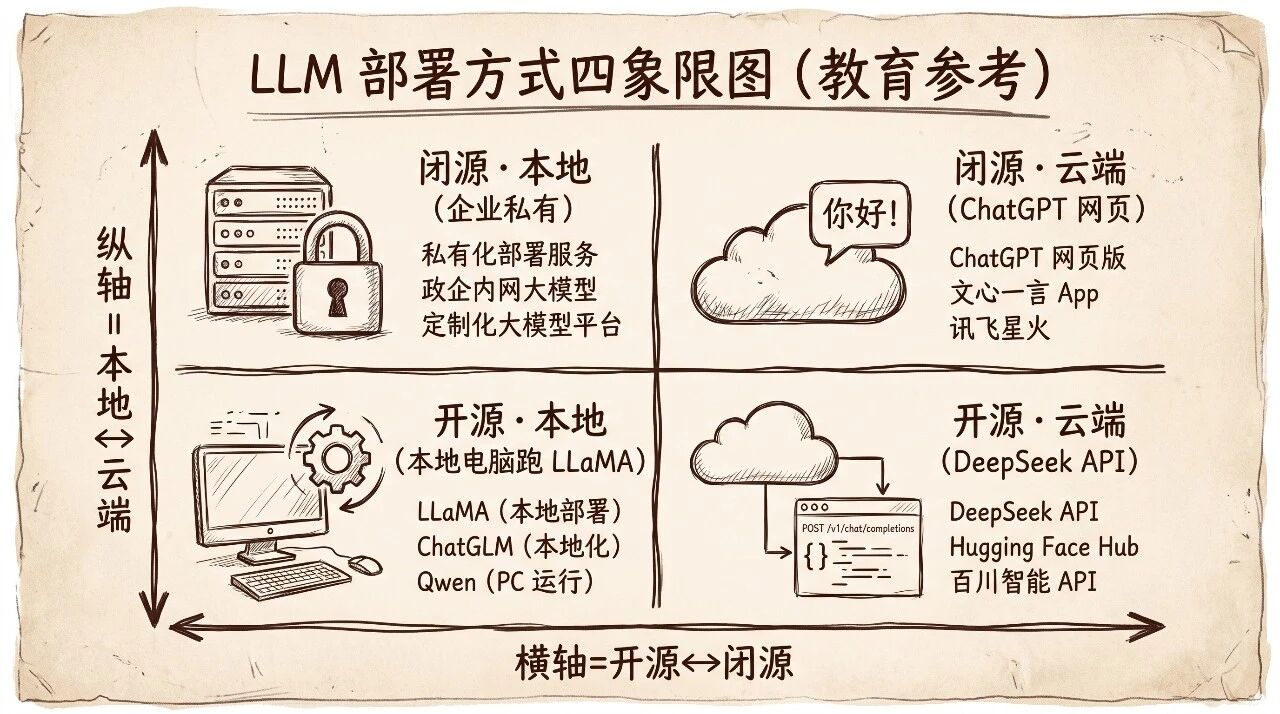
图 2:四种部署形态,选择 = 数据敏感度 × 预算 × 技术能力
8什么是多模态
Multimodal · 不止会处理文字多模态 = 模型能同时处理多种类型的信息。以前的大模型只能"读字"(文字单模态),多模态模型能读字、看图、听声音、生成语音、生成视频、生成图像……
"模态"(Modality)就是信息的载体形式:文字是一种模态、语音是一种、图像是一种、视频是一种、3D 也是一种。一个模型支持的模态越多,能干的事就越多。
9TTS:让机器开口说话
Text-to-Speech · 文字转语音TTS 是 Text-to-Speech 的缩写,你给它一段文字,它给你生成一段能播的音频(人声)。抖音里很多电影解说、客服电话里的"您好我是智能助手"、地图导航的林志玲、郭德纲声音,全都是 TTS。
2026 年的 TTS 已经可以做到:模拟真人语气、克隆特定人的声音(用 10 秒样本)、控制情绪(开心/难过/严肃)、说几十种语言,还能唱歌。
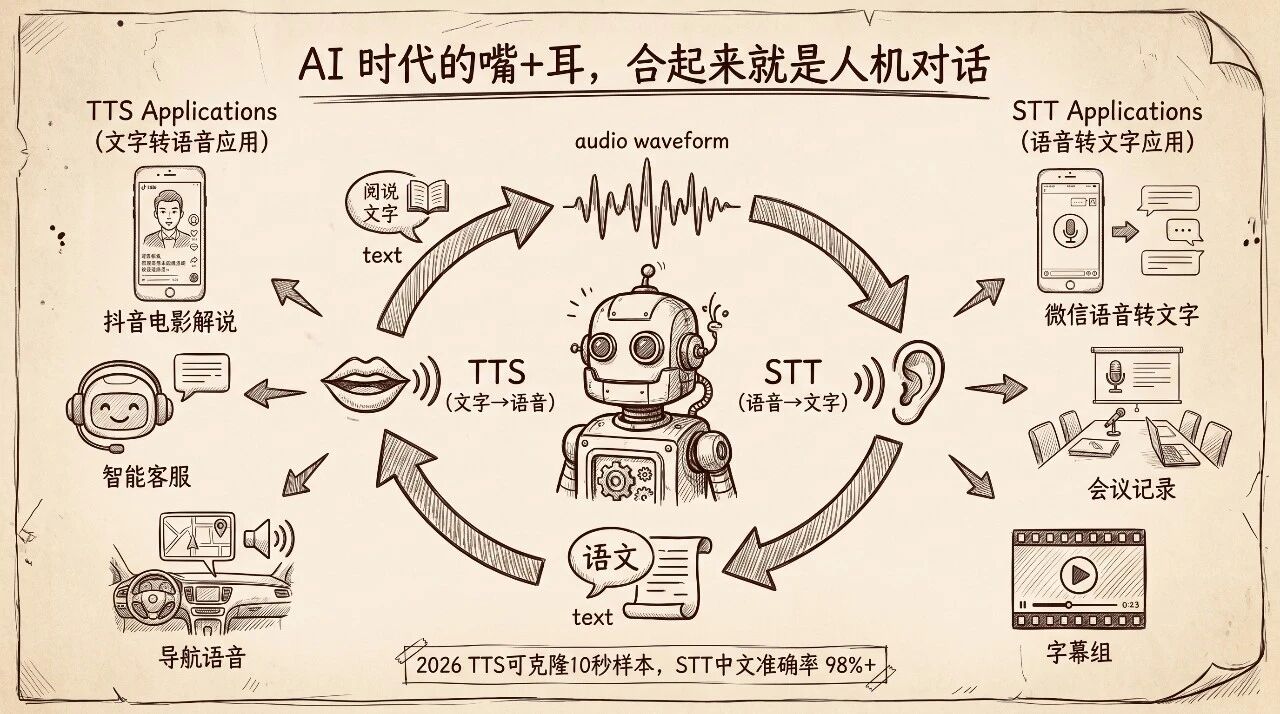
图 7:TTS 和 STT 的双向闭环
10STT:让机器听懂人话
Speech-to-Text · 语音转文字STT 是 Speech-to-Text 的缩写,你给它一段音频,它给你转成文字。和你用的微信"语音转文字"、会议录音自动出纪要、字幕组做字幕,背后都是 STT。
和 TTS 是一对:TTS 是"文字→语音",STT 是"语音→文字"。合起来就是 AI 时代的"嘴+耳"。
11VLM:让机器看懂世界
Vision-Language Model · 视觉语言模型VLM 是 视觉语言模型 的简称,它能同时"看"图像/视频和"理解"语言,并且两者打通:你问它"图里这只猫在干什么",它能告诉你"它在追自己的尾巴"。
它和"传统的图像识别"(CV)的区别在于:CV 只能告诉你"图里有一只猫",VLM 能告诉你"图里有只猫,而且它在追尾巴,背景是客厅",是理解,不是识别。
12图像生成与视频生成
Text-to-Image / Text-to-Video文字 → 图(T2I,Text-to-Image):你描述一段场景,模型给你画出来。代表产品:Midjourney、Stable Diffusion、即梦、豆包文生图。
文字 → 视频(T2V,Text-to-Video):你描述一段动作或故事,模型给你生成一段 5\~60 秒的视频。代表产品:Sora、可灵、Vidu、Runway、Pika。
和 VLM 相反:VLM 是"看懂图",T2I/T2V 是"画出图"。一个吃图,一个吐图。
13RAG:给模型外挂一个"翻书小助手"
Retrieval-Augmented Generation · 检索增强生成
纯 LLM 有一个致命问题:它只知道自己训练时学过的知识,问它"我们公司年假怎么休",它答不上来。
RAG 的思路是:用户问问题时,先去你的专属知识库(公司文档、产品手册、合同……)里把相关内容"翻"出来,连同问题一起丢给模型,让模型"看着资料回答"。
这样模型就有了一个随时可更新的"外接大脑",回答更准、更可控,而且不会因为模型换版本就丢知识。
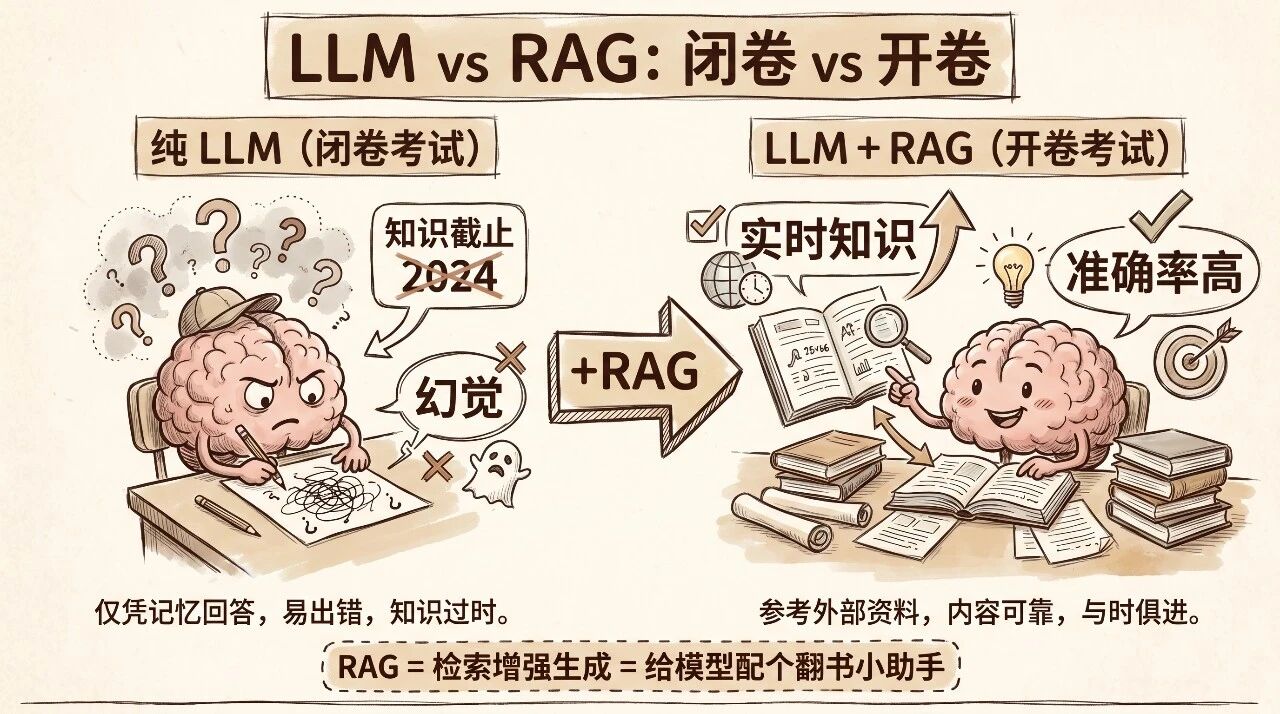
图 3:RAG 的本质,给模型配一个"翻书小助手"
14Agent / 工作流:让模型自己规划干活
AI Agent · 能自主规划的工具使用者
普通 LLM 是"问一答一",Agent 是能自主规划、调用工具、多步执行的"打工人"。你给它一个目标,它自己拆解步骤、决定用什么工具、做完一步看结果再决定下一步。
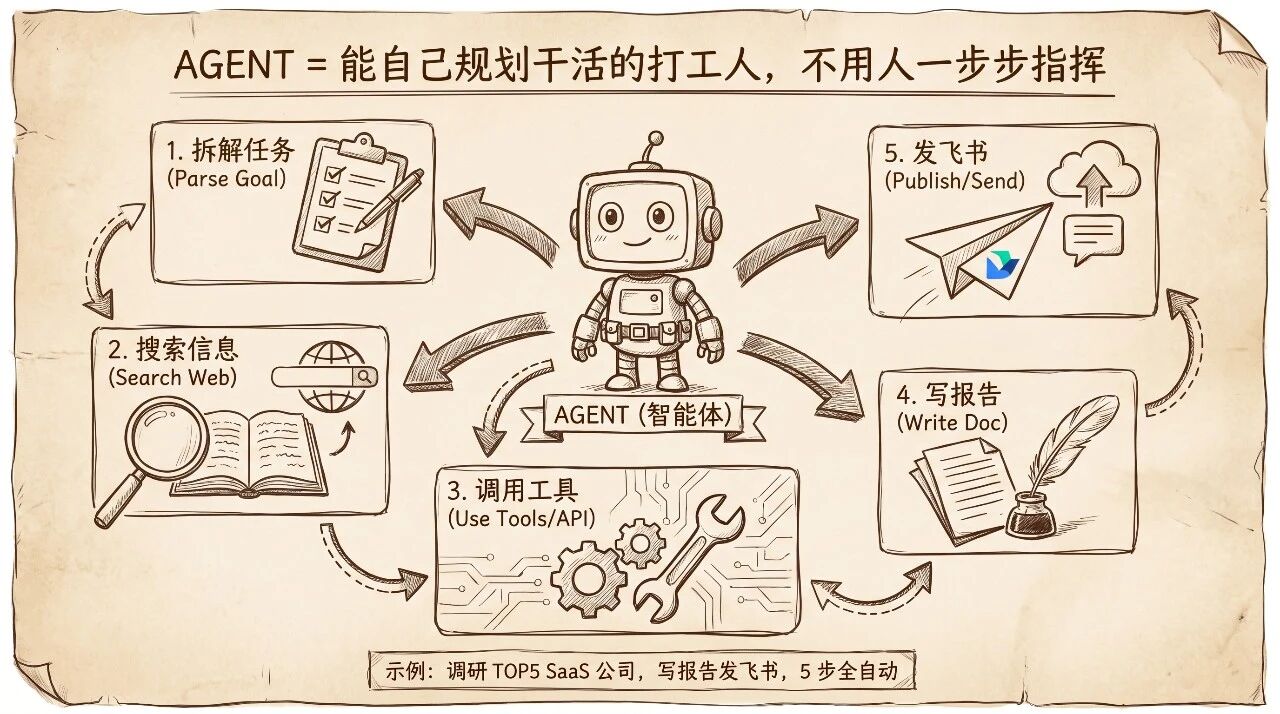
图 8:Agent 工作流闭环
常见的 Agent 能力:调搜索引擎、调 API、操作浏览器、读写文件、执行代码、调用别的 Agent。多 Agent 协作就是"几个 AI 互相配合干大事"。
它会自己:① 拆解任务 ② 搜索 5 家公司信息 ③ 调 RAG 查你的过往报告模板 ④ 写文档 ⑤ 调飞书 API 发布。整个过程你只发了那一句。
15幻觉:模型的一本正经胡说八道
Hallucination · 模型"瞎编"现象幻觉 = 模型自信满满地输出错误信息。它不是"故意骗你",是它"不知道自己在不知道"。比如:模型会编出根本不存在的论文、编造法律条文、虚构不存在的历史事件,而且说得特别流利、特别自信。
为什么会这样?因为模型本质是"猜下一个词",它没有"事实核查"的能力。所以越是不熟悉、越是冷门、越是想不起来的领域,越容易幻觉。
① 关键事实要 RAG 检索,别让模型"凭记忆"答。
② 让模型引用出处,"请告诉我这句话的来源",逼它承认自己编的。
③ 用 Agent 多步验证,一个 Agent 答,另一个 Agent 查,互相挑刺。
16评测基准:怎么给模型"打成绩"
Benchmark · MMLU / GSM8K / HumanEval / etc.评测基准就是给模型"出考卷",用一套标准化的题去测模型在各个方面的能力。常见的有:
看一个模型强不强,先看它在这些"考卷"上的分数。但是,分数高不等于在你要做的事上强,考卷测的是通用能力,你具体场景好不好用还是要自己试。
17小结:把大模型当成什么
把"大模型 + 周边技术"想成一个会干活的数字员工:
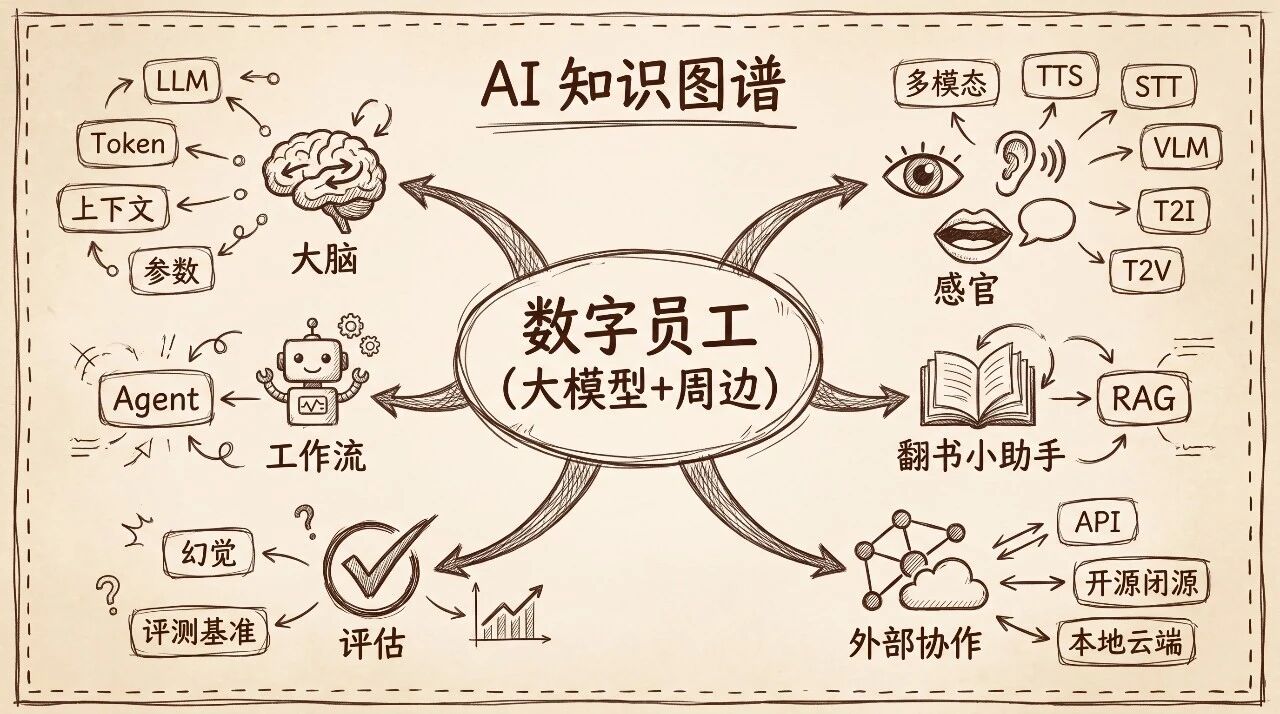
图 9:17 个关键词的心智地图
到这里,你下次再听到同事说"我们用了 RAG + Agent 调 Claude API",你不会再一脸懵,因为每一步拆开你都认得。AI 圈的黑话,本质上就是给"一个能干的数字员工"身上各种部件起的名字而已。
读完打个勾
17 个关键词、9 张图、约 15 分钟。把这篇收藏起来,下次有同事再问"什么叫 RAG / TTS / VLM / Token / Agent",你直接把这篇甩过去就行。
六六爸比(本文作者,85 后科技 IT 爱好者),本文首发于公众号「丁卯生人」。
如果这篇文章对你有帮助,欢迎点下面那张名片关注公众号「丁卯生人」,我每周把亲测的 AI 工具、踩过的坑、写过的自动化流程发出来,不写废话。
📚 往期回顾
六六爸比
一个 85 后科技 IT 爱好者, 公众号「丁卯生人」主理人
每周分享 AI 工具 / 大模型 / 内容创作 / 个人成长