网页抓取排行:第一名一个顶后面六个
大家好,我是六六爸比
一个 85 后科技 IT 爱好者 / AI Agent 深度玩家 / GitHub Trending 追踪员
网页抓取排行:抓取器比浏览器更卷
本期账面
8.9 万
断层领先的榜首
5 万
后六名加起来
2.7 万
喂模型三仓合计
口径:GitHub 星数快照 2026-10-22,q="web scraping" in:name,description;已剔除无关的 Udemy 课程下载脚本 3288 星;定位归类为本号判断。
抓取这件事今年最大的变化,是 agent 逼着爬虫卷起来了。这次排出来的榜,第一名和第二名之间差了六万星。
01
Top 9:断层在第一和第二之间
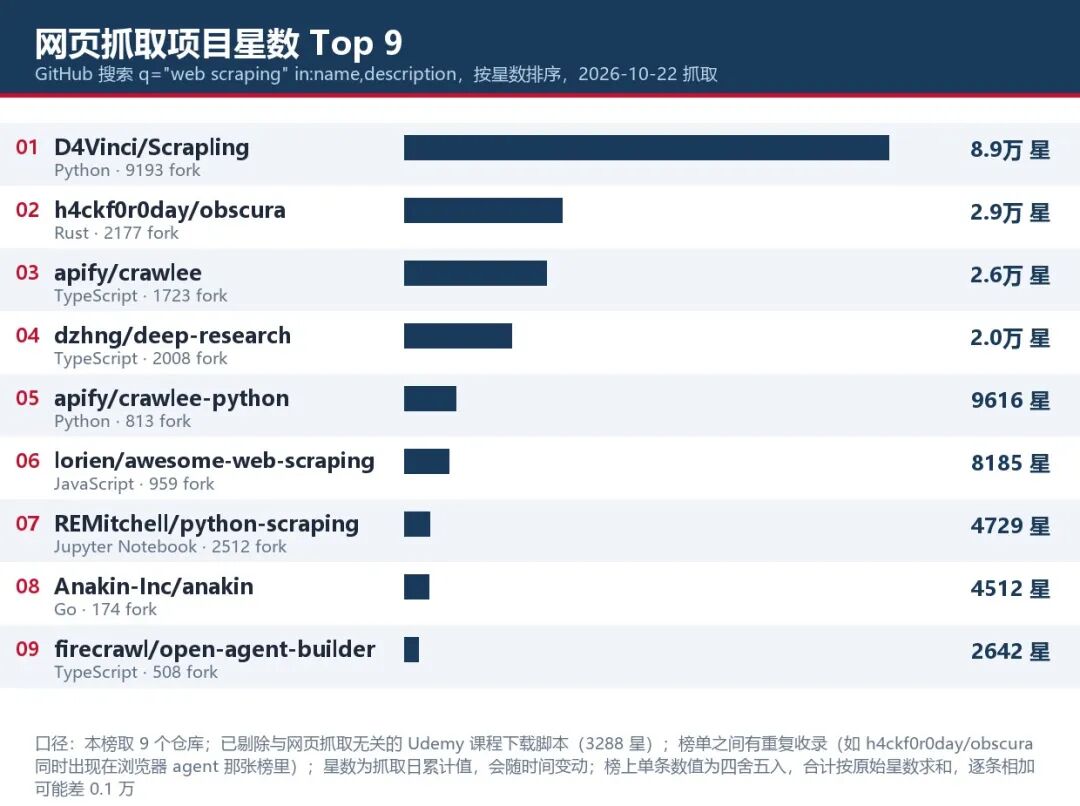
▲ 网页抓取项目星数 Top 9 · GitHub 搜索口径 2026-10-22
第一名的量级像一个独立生态。D4Vinci/Scrapling 8.9 万星,自称是从单个请求到整套爬取流程都能处理的框架。
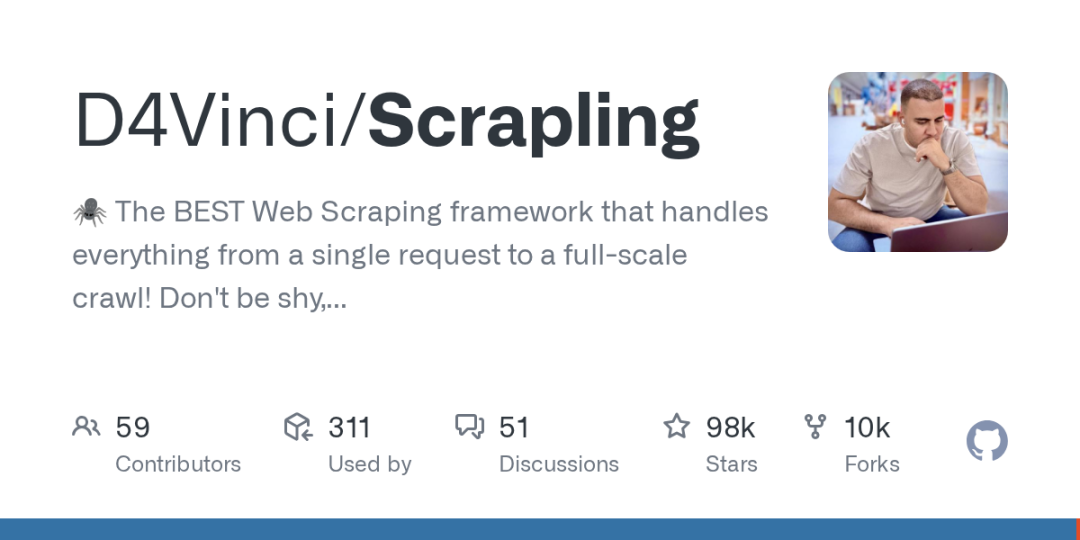
▲ Scrapling 仓库卡片(GitHub)
它比第二名多了六万星,单独就顶得上后面八名加起来的一多半。这不叫领先,叫断层。
第二名 obscura 只有 2.9 万星,是 Rust 写的。它同时出现在浏览器 agent 那张榜里——写给 AI 和网页抓取用的无头浏览器。这说明抓取和自动化正在合流。
中间这一段两只是老牌爬虫库。第三名 apify/crawlee 2.6 万星是 Node.js 的爬虫库,第五名 apify/crawlee-python 9616 星是它的 Python 版。
夹在中间的第四名 dzhng/deep-research 2.0 万星不是爬虫库,是 AI 驱动的深度研究助手。它把搜索引擎、网页抓取和模型接在一起,让 agent 随研究推进自己调方向。
给模型喂文本这件事,已经拆成三个工种。通用框架负责把页面拿到手,浏览器内核型负责绕开检测,直接产出 markdown 那一组负责把结果整理成模型能吃的形状——deep-research、anakin、open-agent-builder 三个加起来 2.7 万星。
模型不吃整页源码,你得先把菜切好——markdown 就是切好的那盘。
第一名一个顶后面六个。Scrapling 8.9 万星,后面六个最小的加起来约 5 万星;整张榜的星数有近一半集中在它一个项目上。
为什么抓取器比浏览器还卷?浏览器 agent 那边的项目多半要接一个真浏览器;抓取这一行从请求层就开始卷:代理自动选择、反检测、直接产出 markdown 和结构化 JSON——anakin 一个仓库就把这三件事都做了!
这九个项目的语言也分散。TypeScript 三个最多,Python 两个,Rust、Go、JavaScript 和 Jupyter Notebook 各一个。
只装一个的话,装哪个?先装 Scrapling:8.9 万星,一个仓库覆盖从单个请求到整套爬取流程,主语言 Python;要批量采集并自己入库,再看 crawlee 那一对。
来源:GitHub Search API,q="web scraping" in:name,description,sort=stars,统计日 2026-10-22。口径说明:星数为统计日累计值;已剔除与网页抓取无关的 Udemy 课程下载脚本(3288 星),上面那张榜为其余 9 个仓库。
02
主流工具全在往「给 AI 喂干净文本」靠
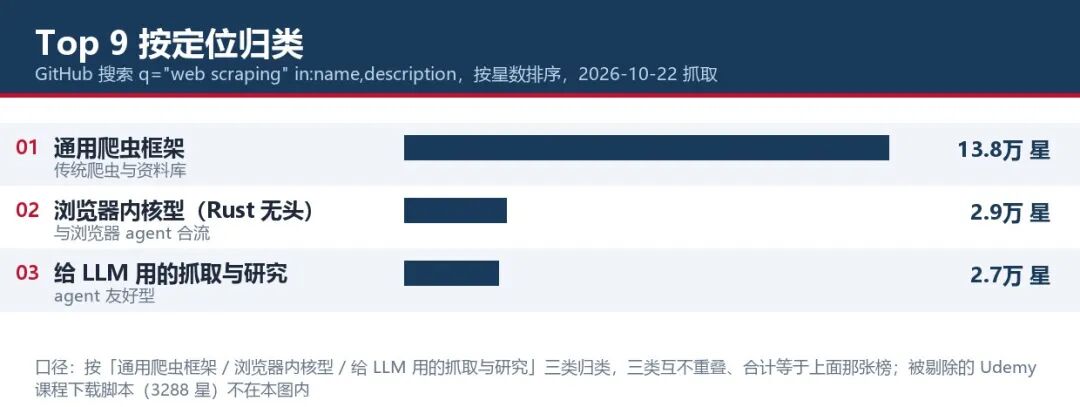
▲ Top 9 按定位归类后的星数合计
有一类项目专门为 agent 而生。deep-research 做迭代式深度研究,anakin 把任意网站转成干净 markdown 或结构化数据,firecrawl/open-agent-builder 给 agent 提供可视化工作流。它们的共同目标不是「爬到页面」,是「爬到模型能直接吃的文本」。
传统爬虫框架并没有因此死掉。crawlee 加上它的 Python 版,加上 awesome-web-scraping 这类资料库,仍然是很多人做批量采集的首选。区别是:以前你的下游是人,现在你的下游是模型。清洗这一环的权重,就这么被推高了。
实际建议。你要「给 agent 一个能读的网页」,别自己写解析,直接找输出 markdown 的工具。要批量采集并自己入库,老牌框架更稳。要的是深度研究而不是采集,deep-research 这类已经封装好了。
别自己写解析。这活工具已经干完了。
来源:GitHub Search API 同一批快照(2026-10-22);归类为本号依据各仓库公开 README 描述所做的判断。
03
抓取这件事的三个判断
先问一句:你的下游是人还是模型?下游是模型,就找直接输出 markdown 或结构化数据的工具(anakin 这类);下游是你自己写代码处理,老牌框架 crawlee 配合它自己的解析器更顺手。
再判断你的目标站点有没有公开接口。很多站点有官方 API 或 RSS,那比任何爬虫都稳。我个人觉得,爬虫应该用在没有正规通道的地方。这不是道德问题,是稳定性问题——官方接口不会因为改版一夜失效!
最后是频率。把并发和请求频率压到不会影响对方的水平。这不是客气,是让你的脚本活得更久。动手之前,先看目标站点的 robots.txt 和服务条款。
怎么自己把榜首那个跑起来。上游给的是三条互斥的装法,按你的场景选一条。
选一条就行,不要都装。
要翻源码就先 clone 下来:
git clone https://github.com/D4Vinci/Scrapling
装法一 · 只发普通 HTTP 请求。用最简的这条,不用装浏览器:
pip install scrapling
装法二 · 要抓有 JS 渲染的页面。先装带 fetchers 的这份:
pip install "scrapling[fetchers]"
再补一条,浏览器内核和系统依赖是这一步下载的:
scrapling install
装法三 · 不想写代码、直接抠正文。装完之后跑交互模式:
pip install "scrapling[shell]"
scrapling shell
先拿一个公开页面练手。不想进交互模式的话,用它的 extract 命令一步出文件,抓的是公开示例站:
scrapling extract get 'https://quotes.toscrape.com/' quotes.txt --css-selector '.quote'
跑完怎么算成功:打开 quotes.txt,里面是它按 .quote 选择器抠出来的内容,不是整页源码——能读到干净的正文,这条链路就算通了!
给你一个能立刻用的组合。要抓公开网页并喂给模型,用 Anakin-Inc/anakin 起服务拿到 markdown,再用 Scrapling 自己的提取器把正文切干净。要抓结构化的商品或文章列表,用老牌框架配自带的解析器。要的是「读完一堆网页然后给我一份报告」,直接用 deep-research 这一类现成的研究代理,别自己从零搭检索加总结那一套。
来源:本段为方法建议,依据各仓库公开 README 的功能描述;未对各方案做抓取成功率横评。
作者:六六爸比。
总结:下游是模型,就别自己写解析,这活工具已经干完了。下期见。
与君共勉:
1. AI 是打破信息茧房的利器。是我们追求信息平等的手段。
2. 警惕上来就忽悠你学各种所谓高大上的工具 Agent, 让你买教程的。
3. AI 时代你只要懂逻辑, 懂中文, 独立思考能力! 一定会有所作为!
4. 与君共勉, 与君一道踏破这 AI 门槛, 让 AI 真正为你所用!
—— 丁卯生人 · 六六爸比
相关 3 篇 + 最新 2 篇——
1.2026-10-13 · Karpathy 一份 65 行文档冲到 21 万星,里面没一行能跑的代码
一份文档怎么变成生产力
2.2026-10-12 · AI 帮你查文献,列的全是假论文?163 个技能逼它句句带出处
科研那条线的技能盘点
3.2026-09-27 · Hermes 官方 9 月排行榜:新增 14 个技能
官方榜的上一期,这次换成安装量口径
4.2026-10-17 · ElevenLabs 按字符收钱、声纹还传云端?5.7 万星开源声音克隆全跑你本地
选 API 之前,先看看本地方案
5.2026-10-16 · 让 AI 写代码总跑偏?GitHub 官方的办法:先把需求写成规格再动笔
工具链怎么定规矩
如果这篇对你有帮助,,转给在选模型的朋友。