向量库排行:第一名是个套壳,真库只有六个
大家好,我是六六爸比
一个 85 后科技 IT 爱好者 / AI Agent 深度玩家 / GitHub Trending 追踪员
向量库排行:第一名是个套壳,真库只有六个
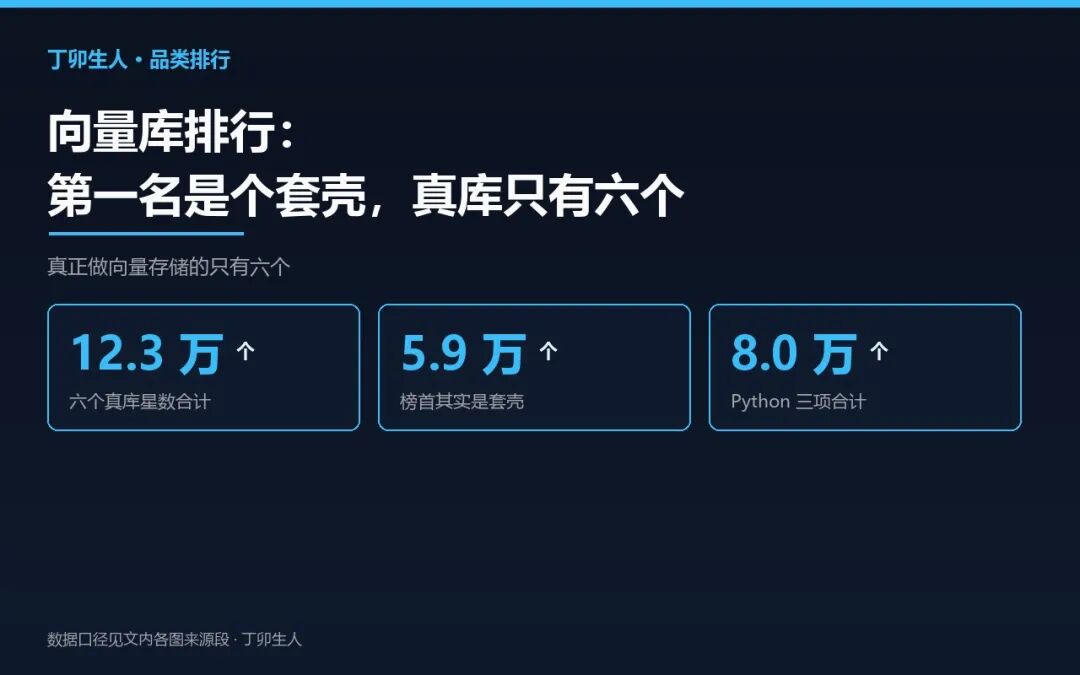
本期账面
12.3 万
六个真库星数合计
5.9 万
榜首其实是套壳
8.0 万
Python 三项合计
口径:GitHub 星数快照 2026-10-22,q="vector database" in:name,description;真库与否按各仓库 README 自述,六个真库占整榜约六成。
搜「vector database」,排第一的 serviette 是个 no-code RAG 服务器(RAG 就是让 AI 先查你的资料再回答),不是向量数据库。第一名不是库?对。这类误排在搜索里非常常见——标题里带了关键词,干的却不是这件事。
01
Top 9:谁是库,谁是套壳
▲ 向量检索相关项目星数 Top 9 · GitHub 搜索口径 2026-10-22
第一名 serviette,5.9 万星,是套壳。pathwaycom/serviette 的定位是「no-code RAG 服务器,让答案始终跟你的文档保持同步」,它把向量库当内部实现——仓库介绍里写的是能接 8 种向量数据库。它冲上第一,靠的是接了一堆库,不是自己就是库。
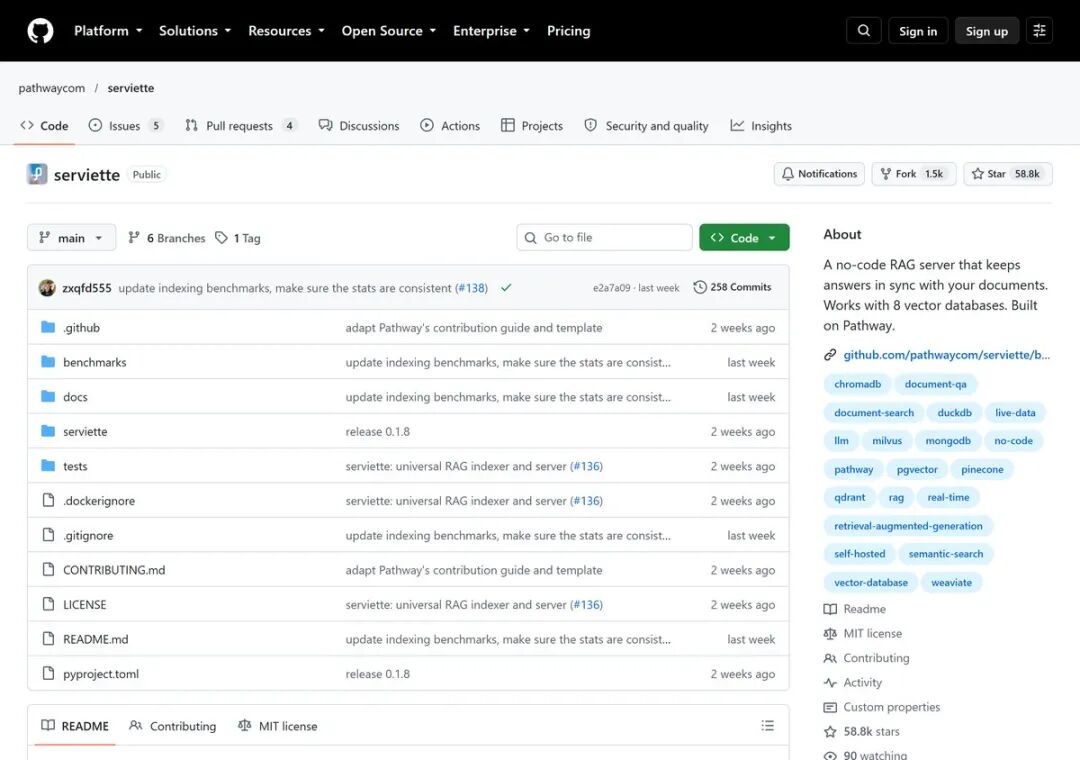
▲ 榜首 serviette:About 自己写明白了——no-code RAG 服务器,接 8 种向量库,MIT
一句话定位:它是给 RAG 用的调度层,不是数据库。
真正的向量库是第二、第三、第五、第六、第七和第八名。milvus-io/milvus 4.6 万星,Go 和 C++ 写的云原生向量数据库,K8s 原生架构;qdrant/qdrant 3.5 万星,Rust 写的,主打高性能和大规模。
weaviate/weaviate 1.7 万星,开源的向量数据库;alibaba/zvec 1.6 万星,是阿里的轻量级进程内向量数据库,C++ 写的。第七名 objectbox-java 和第八名 cozodb/cozo 也是真库。
中间插着的第四名,不是向量库。
第四名自己不做存储,它管的是调度。rocketride-org/rocketride-server 1.8 万星,是带 C++ 核心的 AI 流水线引擎,带 VS Code 扩展、TypeScript 和 Python SDK,还有 Docker 部署。
来源:GitHub Search API,q="vector database" in:name,description,sort=stars,统计日 2026-10-22。口径说明:星数为统计日累计值;「是否为向量数据库」的判断依据各仓库公开 README 自述。
你要不要向量库
装之前先过三个判断,一条都不中,就不用装:
数据量是不是大到搜不过来?百万以内、并发不高,你已经在用的 Postgres 这类数据库就够,别单独养一套向量库;上千万并且要高并发,才轮到 Milvus、Qdrant 这个量级。
数据要不要持久化?要长期存、反复查的,选能落盘的:Qdrant 把数据落在挂载的目录里,milvus-lite 落成一个本地库文件;只是临时算一把,就不用纠结这条。
要不要混合检索?要把向量和关系、图放在一套事务里一起查,这张榜上只有 cozodb/cozo 一个能做到。
02
语言分布:同一语言合并后,Python 最多
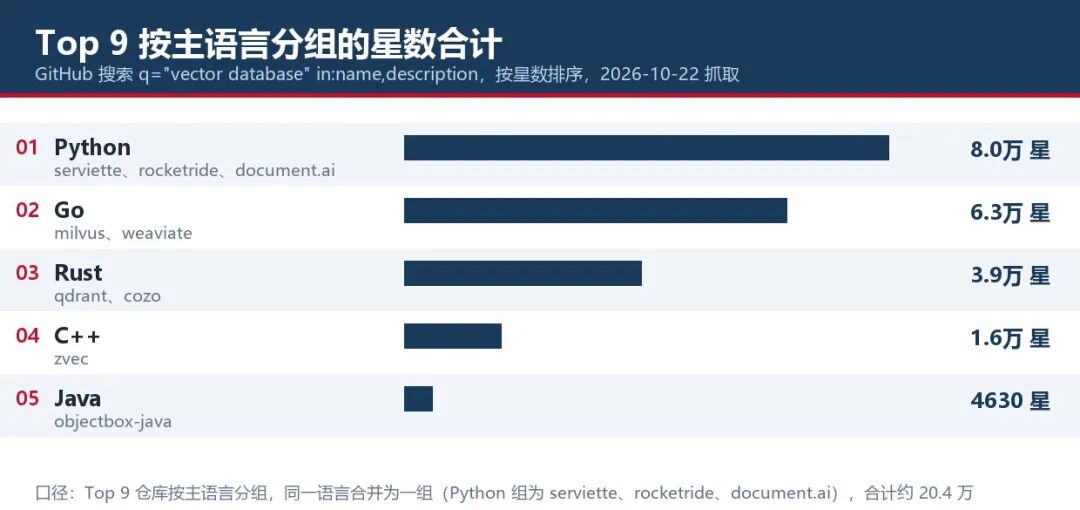
▲ Top 9 按主语言分组的星数合计(同一语言已合并,合计等于上面那张 Top 9 榜)
合并同语言之后,这行的主力是 Python。Python 占了三个项目——serviette、rocketride-server、document.ai,合计 8.0 万星;Go 两个 6.3 万,Rust 两个 3.9 万,这三个语言加起来是整张榜的九成,C++ 和 Java 两种加起来约一成。
先看断层,而且断层不在套壳和真库之间。第一名 serviette 5.9 万星到第二名 milvus 只差 1.2 万,比真库内部 milvus 到 weaviate 的 3.0 万还小。六个真向量库加起来 12.3 万星,占了整张榜的六成。
第七、第八名也是真库,只是形态完全不一样。objectbox/objectbox-java 4630 星,仓库介绍写的是「给 Android 和 JVM 用的数据库,轻量、跑在设备上的向量库」,话题标签里也有 vector——它是真库,只是跑在手机和 JVM 里,不联网。
cozodb/cozo 4134 星,Rust 写的,仓库介绍写的是「事务型的关系-图-向量数据库,用 Datalog 查询」,事务、关系、图、向量四种数据一起管,介绍里把它叫作「AI 的海马体」。把关系、图、向量放在一套事务里管,这榜上只有它一个。
那三个 Python 项目,自己都不做向量存储。共同点是往上包了一层:serviette 是 RAG 服务器,rocketride-server 是 AI 流水线引擎,document.ai 是本地知识库方案。
其中 serviette 和 rocketride-server 更像「向量库的调度层」:把一排向量库接进来,再往上提供一层自己的东西,一个给文档问答用,一个给 AI 流水线用,两个加起来 7.7 万星,接近整张榜的四成。
GitHub 搜索这个门卫,只认名字和介绍:工牌对得上就放行,是不是真干这行的,它不管。所以进榜的是三类东西:真向量库、接向量库的流水线引擎、自己不做存储但名字里带关键词的套壳。
分清楚这一点,这张榜才有正确的读法。
九个上榜项目里,自己就是向量库的,只有六个!
选型建议,按你的规模来。数据量在百万以内、并发不高,Postgres 这类你已经在用的数据库就够(Postgres 不在这张榜里,属榜外对照),别单独维护一套向量数据库。先看你手上已经养着哪个数据库,再决定要不要多养一个。
上千万并且要高并发,Milvus 和 Qdrant 二选一:milvus 偏云原生集群,qdrant 偏单机的高性能和大规模。
要在自己的应用里跑、要单进程、要快,zvec 这类进程内方案值得试,它自己就是 C++ 写的,定位就是轻量。要的是图和关系一起查,cozodb/cozo 是 Rust 写的;要在手机和 JVM 里跑,objectbox-java 是榜上唯一的一个。
想直接装一个试手感,从这三个开始。Qdrant 官方 quickstart 给的 Docker 启动命令是:docker run -p 6333:6333 -p 6334:6334 -v "$(pwd)/qdrant_storage:/qdrant/storage:z" qdrant/qdrant,起来之后 REST 接口在 6333,gRPC 在 6334,数据落在挂出来的 qdrant_storage 目录里。
($(pwd) 是 bash 写法;上游 quickstart 另写明,Windows 上建议改用命名卷,而不是挂本地目录。)上游还提醒一句:默认不开加密也不开鉴权,任何能访问到你这台机器的人,都能连上这个容器。
Milvus 官方给了单文件的本地版。pip install "pymilvus[milvus-lite]" 就能建一个本地向量库;上游 README 给的建库第一动作是 from pymilvus import MilvusClient,再 client = MilvusClient("milvus_demo.db") 建一个本地库文件。
要连远端的 Milvus,就装它的 Python SDK:pip install -U pymilvus。Milvus 本身是集群架构,要自己起一整套,才需要 clone 源码照 README 编译:git clone https://github.com/milvus-io/milvus。
这一步需要两个 key,没有就先别装。没有 key 的不用卡在这:上面 Qdrant 起容器、milvus-lite 建本地库文件,步骤里都没有要 key 的环节,先拿那个试手感。
榜上第一那个 serviette 是 Python 包,pip install serviette 就能装上(上游要求 pip 23.1 以上,装之前先跑一次 python -m pip install -U pip,旧 pip 解析这棵依赖树会卡几个小时)。
它跑在 Pathway 上,要先去 https://pathway.com/framework/get-license 领一个免费授权码,再放进环境变量:macOS / Linux 跑 export PATHWAY_LICENSE_KEY=...,Windows 的 PowerShell 跑 $env:PATHWAY_LICENSE_KEY="..."。
上游给的是四条命令,其中还有一条 OpenAI 的 key 也要放进去:export OPENAI_API_KEY=sk-...,最后跑 serviette demo --embedder openai 才会起服务(起在 http://localhost:8989)。要本地嵌入能力,就装带本地依赖那一版 pip install "serviette[local]" --extra-index-url https://download.pytorch.org/whl/cpu。
这三个仓库就在上面那张榜里,clone 完先读 README,别照着过期的教程装版本~
来源:GitHub Search API 同一批快照(2026-10-22);主语言为仓库作者标注值;分组只按同一批 Top 9 的主语言合并,合计等于上面那张 Top 9 榜。
作者:六六爸比。
总结:百万以内别养向量库,千万以上再谈 Milvus 和 Qdrant。榜是地图,规模才是选型依据。下期见。
与君共勉:
1. AI 是打破信息茧房的利器。是我们追求信息平等的手段。
2. 警惕上来就忽悠你学各种所谓高大上的工具 Agent, 让你买教程的。
3. AI 时代你只要懂逻辑, 懂中文, 独立思考能力! 一定会有所作为!
4. 与君共勉, 与君一道踏破这 AI 门槛, 让 AI 真正为你所用!
—— 丁卯生人 · 六六爸比
相关 3 篇 + 最新 2 篇——
1.2026-10-05 · LightRAG 4.0 万星 · 1 行启动 RAG
知识库那条线的入门款
2.2026-10-05 · 18.8 万星的 MarkItDown:微软官方,把万物一键转成 Markdown
文档进 AI 的第一道工序
3.2026-10-12 · AI 帮你查文献,列的全是假论文?163 个技能逼它句句带出处
科研那条线的技能盘点
4.2026-10-17 · ElevenLabs 按字符收钱、声纹还传云端?5.7 万星开源声音克隆全跑你本地
选 API 之前,先看看本地方案
5.2026-10-16 · 让 AI 写代码总跑偏?GitHub 官方的办法:先把需求写成规格再动笔
工具链怎么定规矩
如果这篇对你有帮助,,转给在选模型的朋友。