AI 帮你查文献,列的全是假论文?163 个技能逼它句句带出处
⭐ 觉得有用?关注公众号「丁卯生人」
每月发干货 · AI Agent · GitHub · 装修避坑
大家好我是六六爸比,一个 85 后科技 IT 爱好者。
我有个朋友在读博,每次吃饭都在吐槽同一件事——导师让他用 AI 查文献,AI 倒是给列了一堆,点开一看,论文全是编的,连 APA 格式都编得有模有样。这不是段子。科研这地方对 AI 的容错率是零,错一个引用,整篇论文就被导师打回来。
这周翻 GitHub Trending,翻到一个 Python 项目 K-Dense-AI/scientific-agent-skills,比 9-08 那次又涨了 +4,414,总星 42,300(这是 9-03 的 trending 快照;10-10 实测已经 48,234,下文我按实测数说)。定位一句话——"Turn any AI agent into an AI Scientist",把任何 AI agent 武装成 AI 科学家。这不就是我朋友要的东西?今天拆给你看。
一、它是什么:给 AI 装上一套科研技能包
K-Dense 开源的科研技能库,163 个开箱即用的技能,外加 100 多个真实数据库接口。README 里写 163 个技能,trending 描述写 165——这点小出入不影响判断,要紧的是它干的事:不教 AI 变聪明,是给它接上真数据。
官方描述:
Turn any AI agent into an AI Scientist. The #1 Agent Skills library for science, used by 190,000+ scientists worldwide. 165 ready-to-use validated skills plus 100+ scientific databases covering biology, chemistry, medicine, and drug discovery.
还有个变化得先说一句:这项目原来叫 Claude Scientific Skills,最近改成了 Scientific Agent Skills。技能没变,变的是胃口——从"只伺候 Claude"变成"任何支持开放 Agent Skills 标准的 agent 都能用"。官方现在点名兼容 Cursor、Claude Code、Codex、Google Antigravity,社区里 OpenClaw、NemoClaw、Pi、Hermes 也都能挂。
163 个技能是怎么分布的
100+ 数据库接口:一个统一的 database-lookup 技能直连 78 个公共库(PubChem、ChEMBL、UniProt、COSMIC、ClinicalTrials.gov、FRED、USPTO 等),另有 DepMap、PrimeKG、Imaging Data Commons 等专用技能;BioServices 再带约 40 个生信服务、BioPython 带 39 个 NCBI 子库、gget 带 20 多个基因组库。所谓"100+"是这么叠出来的,不是某个单一数据库有 100 张表。
70+ Python 包技能:RDKit、Scanpy、PyTorch Lightning、scikit-learn、PyTDC、pydicom、pymatgen、Qiskit、OpenMM 这些,给版本感知的标准流程。
9 个平台集成:Benchling、DNAnexus、LatchBio、OMERO、Protocols.io、Ginkgo Cloud Lab、LabArchives、Opentrons、Open Notebook。
30+ 分析与写作工具:文献综述、可溯源科研写作、保密审稿、Paperclip(全文文献与 FDA/PMDA/EMA filings 逐行引用)、海报与示意图生成。
10+ 研究与临床工具:假设生成、基金写作、PK/PD 建模、BIDS、ISO 13485/14971 合规准备、分析方法验证。
先把项目档案摊开
项目:K-Dense-AI/scientific-agent-skills | 协议 MIT | 最新版 v2.66.0(2026-09-02)
主语言:Python 约 8.1 MB 源码,另有 TeX / HTML / BibTeX Style / Shell
形态:技能包,不是独立软件——挂进你已经在用的 agent;仓库同时是一个 Agent Plugins 包(含 plugin.json)
跑起来要什么:Python + uv 包管理器;系统支持 macOS / Linux / Windows(需 WSL2)
空间占用:仓库 243.2 MB,大头是 167 张技能示意图;技能自身的 Python 依赖由各自 SKILL.md 声明,科学计算包会额外占不少
热度:48,234 星(2026-10-10 实测)| 4,339 fork | 仅 23 个 open issue
增长:9-08 到 10-10 净涨 +4,414 | 官方称 19 万+ 科研用户在用(Trending 2026-09-03 抓取)
时间线:2025-10-19 创建,约十一个月做到 4.82 万星;8-17 到 9-02 三周内发了 v2.64 / v2.65 / v2.66 三个版本
学术与入口:论文 arXiv:2609.00065 | 桌面端配套 K-Dense BYOK | 社区 Discord / X / YouTube
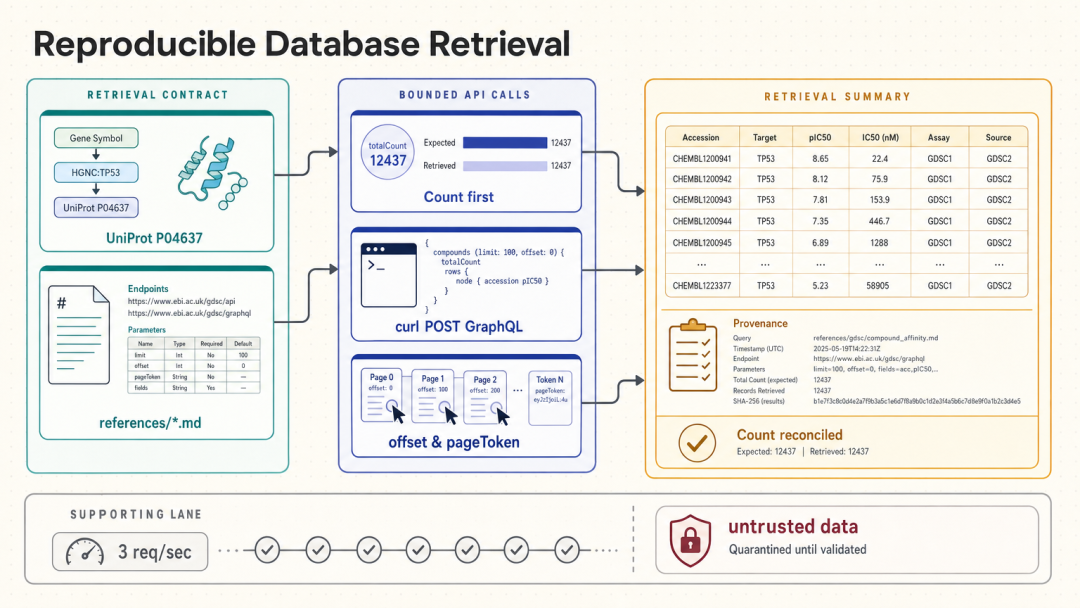
▲ 一个 database-lookup 技能的实际工作方式:先定检索契约,再做有界 API 调用,最后核对返回数量并留下 Provenance(含结果 SHA-256 哈希)。右侧那张表每一行都能追到源文件——这就是"引用是真的"的底层机制。
二、为什么之前的方案都不行
在 scientific-agent-skills 出现之前,"AI 帮科研"这件事的常见做法我都看过,每个都有硬伤:
ChatGPT 直接问。GPT-4 答医学问题准确率大约 70%——听上去不低,但科研场景错 30% 等于不能用。一个错引的论文,会让整个研究结论报废。
专业医学 LLM(如 Med-PaLM)。准确率高一些,但要付费、要排队、不能本地部署。科研人员特别看重"数据隐私"——未发表的实验数据传上去,等于免费送给科技巨头。
本地 RAG(自己拼)。科研人员自己用 LangChain + 向量数据库 + 论文 PDF 拼一套 RAG。折腾两周,准确率还是不稳定——因为 PDF 格式千奇百怪,表格、公式、化学结构图提取出来全错。
这些方案的共同问题:通用 AI 不懂论文格式、不认识化学结构、不接专业数据库。科研人员要的不是更聪明的 AI,而是"懂科研"的 AI。
三、走一遍:装一条命令,跑六类流水线
它不是一个要打开的软件,而是装进你现有 agent 的一包技能。装完之后,你在 Cursor 或 Claude Code 里用自然语言派活就行。
装:一行命令
官方推荐的标准安装方式:
npx skills add K-Dense-AI/scientific-agent-skills
这条命令覆盖 Claude Code、Codex、Gemini CLI、Antigravity 等支持 Agent Skills 的宿主。想用 GitHub CLI,gh skill 支持交互式浏览、按名字装单个技能、指定宿主、锁定到某个 release tag 或 commit SHA,还能查更新。装完的落盘位置是 ~/.codex/skills、.agents/skills 这类目录,具体看宿主文档。
六条示例流水线:官方给的原话目标
药物发现:为临床前肺癌研究筛选 EGFR 抑制剂候选(查 ChEMBL 的 IC50)
单细胞 RNA-seq:10X Genomics 数据全流程分析,并整合公共数据
多组学生物标志物:整合 RNA-seq、蛋白质组、代谢组预测病人结局
虚拟筛选:寻找蛋白-蛋白相互作用的别构调节剂
变异证据审阅:为遗传肿瘤研究标注合成或已脱敏的 VCF
系统生物学:从 RNA-seq 数据构建并分析基因调控网络
README 里还留了 docs/examples.md 收录更完整的工作流样例。注意第二条的例子写的是"合成或已脱敏的 VCF"——涉及病人数据时它自己就把边界划清了。
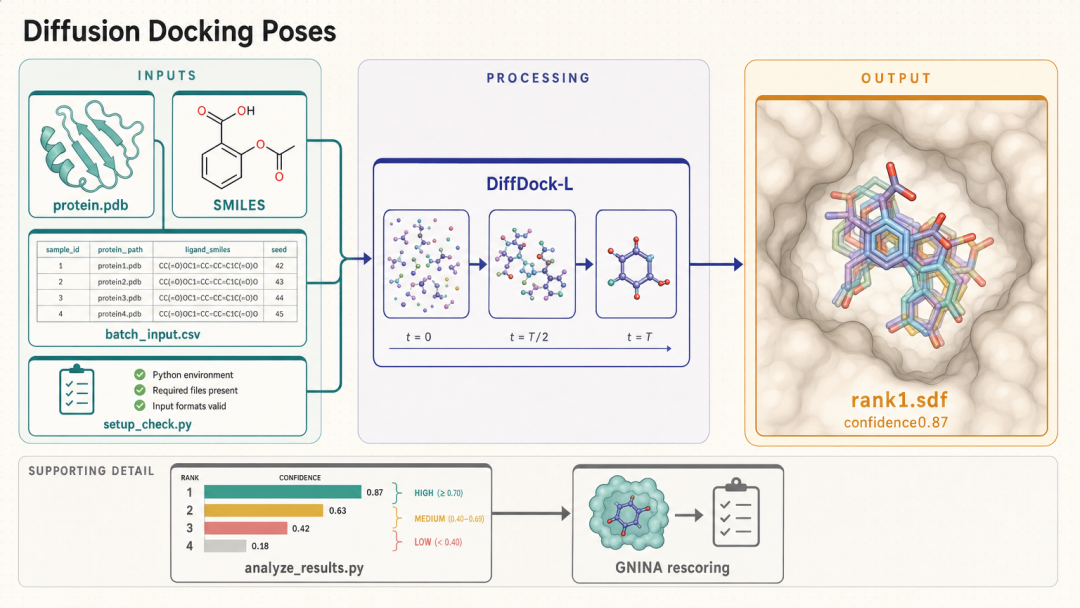
▲ 虚拟筛选这条流水线的技能示意图:左边喂 protein.pdb 和 SMILES,中间 DiffDock-L 做扩散对接,右边出 rank1.sdf 带置信度,再用 GNINA 重打分。每一步的输入输出都是确定的文件,不是"AI 说它做了"。
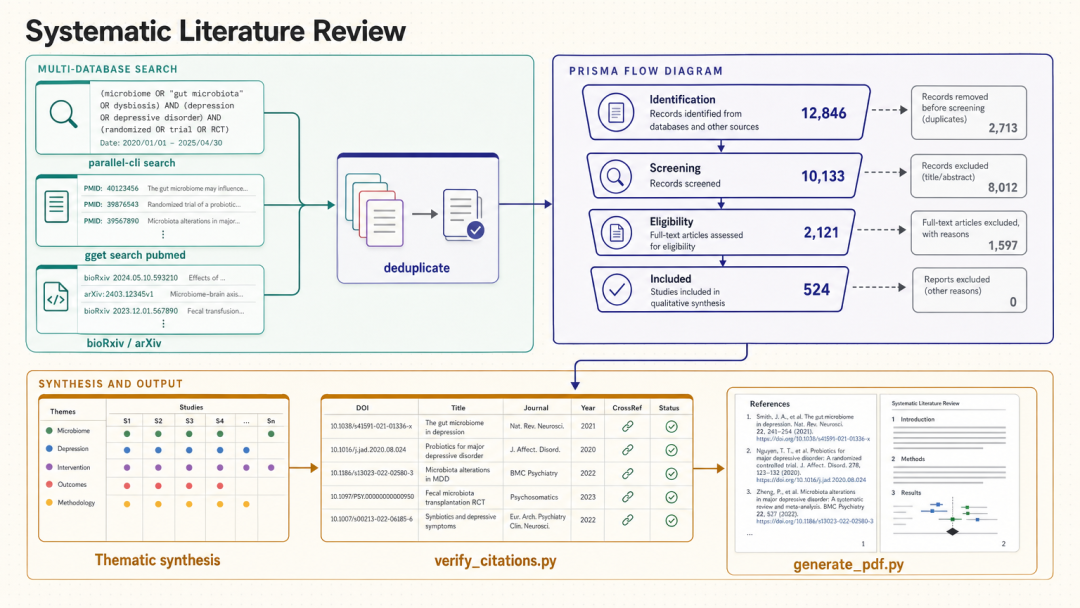
▲ 文献综述技能的演示
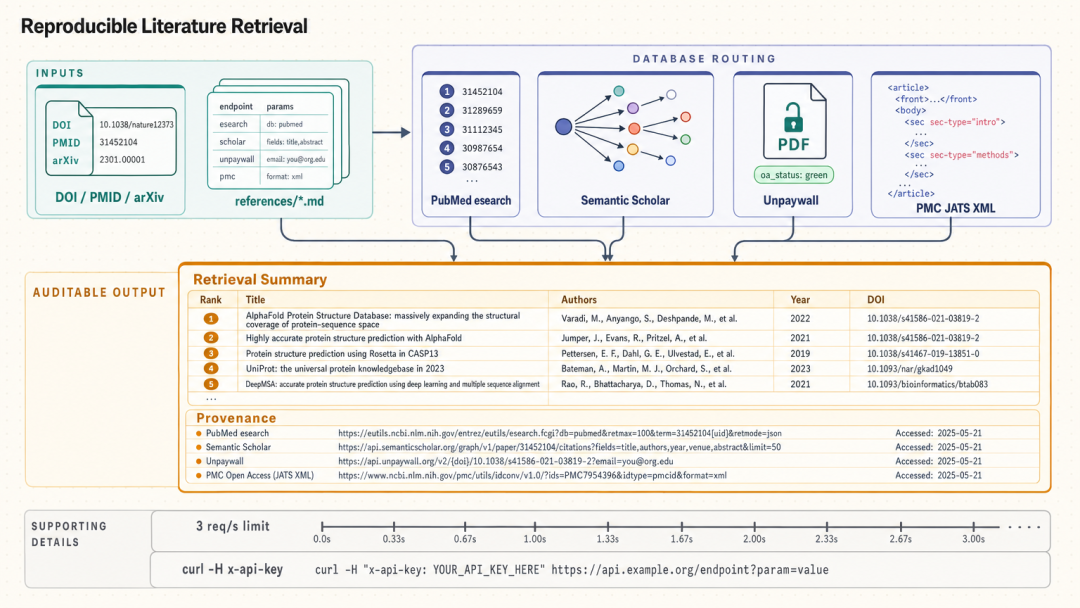
▲ 查论文技能的演示
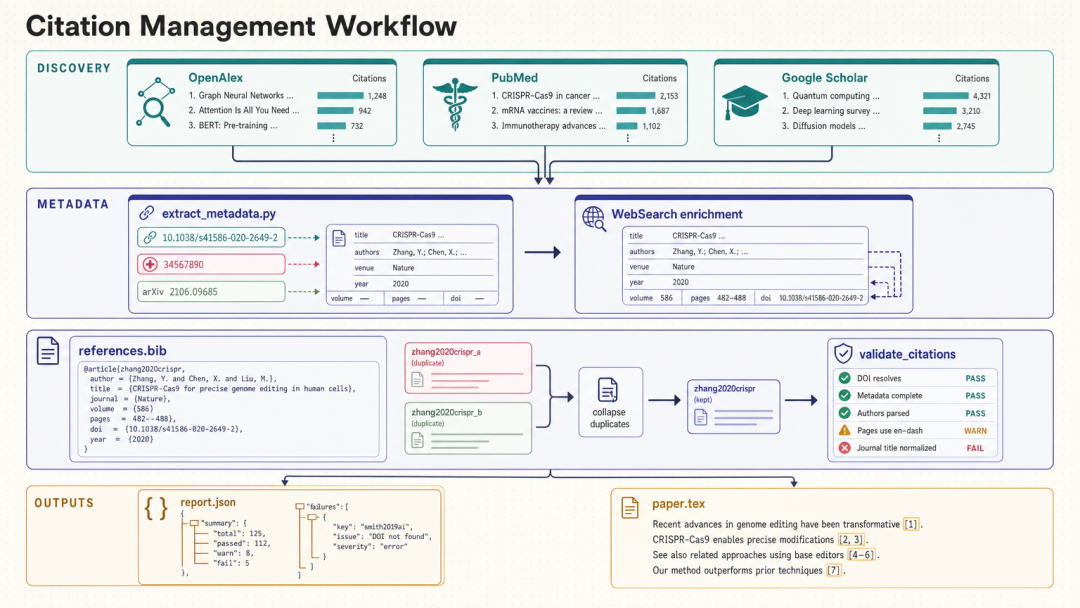
▲ 引用管理技能的演示
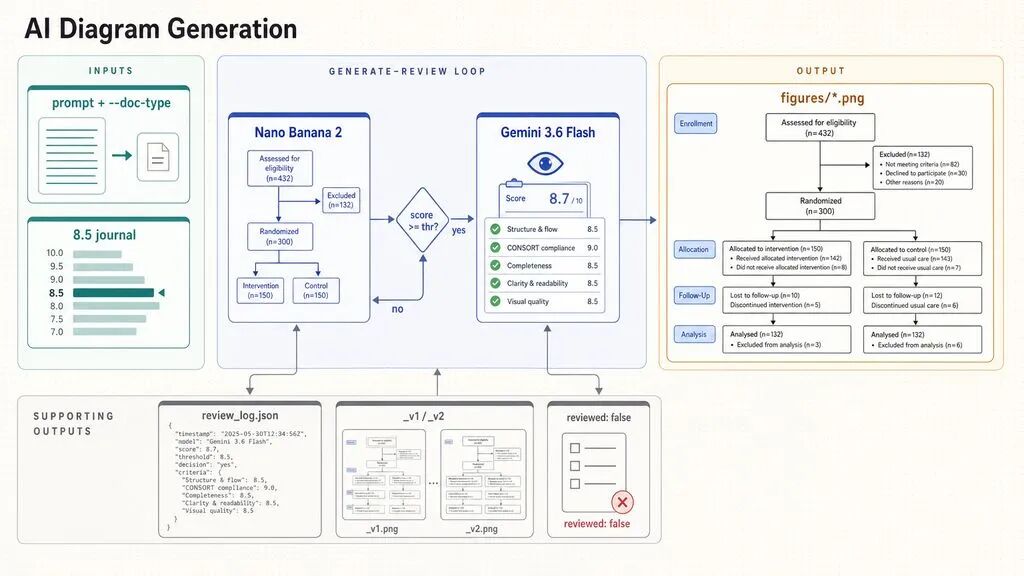
▲ 科学示意图生成技能的演示
它凭什么敢写"validated"
每个技能都带 SKILL.md 文档、代码样例、用例和集成指南;凡是带 scripts/ 的技能必须有测试套件,仓库有两条 CI——security-scan 和 skill-tests,缺测试的 PR 会被直接挡住。"已校验"不是宣传词,是有 CI 兜底的。
四、横向看,它站在哪
sci-agent-skills|163 技能 + 100+ 数据库 · 带 CI 校验 · 兼容多 agent
ChatGPT|通用 · 易幻觉 · 引用经常错
Med-PaLM|医学专用 · 收费 · 不本地 · 数据上云
自己拼 LangChain|折腾 · 准确率不稳 · 维护成本高
BioGPT 等专用 LLM|单领域强 · 不通用 · 要训练
它跟其他方案最大的差异:不是训练一个新 AI,而是在已有 AI 上"加装"科研能力。这思路很像智能手机——不是每家都自己造系统,而是在 Android/iOS 上装 app。
数据也支持这个判断:48,234 星、4,339 fork,open issue 只有 23 个——四万八千星的项目能把待办压到这个数,维护质量可见。trending 的 collaborator 里有 TKassis(项目主导)、cursoragent、borealBytes、claude,是跨学术界和 agent 圈的合作模式。
五、装起来:三种方式,加 5 件要先知道的事
三种装法
① npx(推荐):npx skills add K-Dense-AI/scientific-agent-skills,一条命令,覆盖主流宿主。
② GitHub CLI:gh skill 交互式浏览、单装某个技能、指定宿主、锁 tag 或 SHA。
③ Agent Plugins:Cursor 把仓库软链到 ~/.cursor/plugins/local 再 Reload Window,在 Customize 里确认;Codex 走本地 checkout。
④ 手动:git clone 到 ~/.agents/skills/(用户级)或 .agents/skills/(项目级)。
▲ 不想装进现有 agent:K-Dense 托管 Web 工作台,开个会话就能派科研活(官方演示动图)
想要桌面端:K-Dense BYOK
不想配 agent 的话,同团队还开了一个 K-Dense BYOK:免费的桌面端 AI 科研助手,自带 API key、可选 40 多个模型,把这套技能连同联网检索、文件处理、100 多个数据库打包成一个研究工作台。

▲ BYOK 桌面端实录:Kady 跑完一次单细胞 RNA-seq 全流程——左 Sandbox 右 Chat,交叉验证每个数字(官方演示动图)
动手前的 5 件事
1. 官方自己提醒:技能仍要你自己扫一遍。README 的 Security Disclaimer 写得很直白——这些技能是团队在资源有限的情况下尽力审过的,但第三方技能装之前建议本地再扫一次:uv pip install cisco-ai-skill-scanner 然后 skill-scanner scan /path/to/skill --use-behavioral,发现可疑行为直接提 issue。愿意把这句写在首页的项目,反而让人放心。
2. 163 个技能不等于你全用得上。按领域挑:做药化先看 RDKit / DiffDock / MedChem,做组学先看 Scanpy / gget / bulk-rnaseq,写论文先看 literature-review / citation-management / Paperclip。整包塞进去会占上下文,效果反而差。
3. 依赖是真要装的。技能用 uv 管 Python 依赖(macOS/Linux 一条 curl 装好,Windows 用 PowerShell 脚本),科学计算包动辄几个 GB;系统层面 Windows 得走 WSL2。
4. 数据出不出本机,取决于你配的模型。技能本身在本地跑,但推理走你填的 API key。未发表数据敏感的话,配本地模型(Ollama 这类)或走 BYOK 自己控。涉及病人样本时,照官方例子那样用合成或已脱敏数据。
5. 版本节奏很快。8-17 到 9-02 三周内发了 v2.64 / v2.65 / v2.66 三个版本,技能清单和接口会动。生产环境建议锁 release tag 或 commit SHA,别跟着 main 分支跑。
六、适合谁,以及我的判断
适合谁
研究生 / 博士生:写论文查文献的效率直接翻 3 倍,省下的时间用来真正做实验
生物医药公司研究员:药物筛选、靶点发现、文献综述,AI 帮人做能省大量时间
科技查新 / 专利分析员:查全、查准、查快,这是这个工具的核心优势
高校老师:备课、写综述、审稿都能用上
我的判断
AI 进科研,最大的拦路虎不是"AI 不够聪明",是"AI 不知道哪条信息是真的"。scientific-agent-skills 给的答案是把"查"这件事做成技能——直连数据库、留下能追溯的检索记录、每个技能带测试。它没让模型变强,它让模型说的话能被核对。
这条路我觉得才是科研 AI 真能落地的样子:与其干等一个"科学大模型",不如在现有 agent 上接一层确定性的工具和数据。改名那一步也透出团队的判断——生态不归任何一家 agent,谁都可能成入口。
仓库地址:github.com/K-Dense-AI/scientific-agent-skills,桌面端配套看 K-Dense BYOK。
数据来源:GitHub Trending 周榜嵌入数据(2026-09-03 22:30 CST 抓取);星数/fork/issue/版本取自 GitHub API 2026-10-10 实测(9-08 到 10-10 净涨 +4,414,仓库最后推送 2026-10-05);技能清单与安装方式出自仓库 README v2.66.0;论文 arXiv:2609.00065。
—— 六六爸比 · 一个 85 后科技 IT 爱好者
AI 与君共勉
关于科研:AI 不是来替科研人员的,它是个好使的"杂活处理员"。把那些"必须做又不增值"的事丢给它,你腾出手干真正要创造力的部分。
关于选工具:科研工具就看两样——背后接的是不是真数据源(不是 AI 凭记忆编的),有没有同行评议(不是开发者自己说好用就算)。
关于幻觉:AI 答科研问题,第一个动作永远该是"让它给来源"。给不出来,再准的答案也不能用。scientific-agent-skills 这种直连数据库的路子,本质就是在治"幻觉"。
关于学生:研究生第一年该学的不是写论文,是"怎么用 AI 工具把自己的文献阅读提速"。三年前这门课还不重要,现在不学,就落后一代。
往期文章 · 10 篇精选
① 2026-09-05 · 清华把一间教室,开源给了所有 AI:OpenMAIC 拆解
② 2026-08-20 · 当 Model 决定上限、Harness 决定下限:DeepSeek 正在重写 AI Agent 的规则
③ 2026-08-12 · AI 时代的旅行:5 个 SKILL.md 跨 WorkBuddy/Coze/Dify 复用
④ 2026-08-05 · FFmpeg 9.0 代号 Lei 正式发布
⑤ 2026-08-01 · Reasonix 1.x 正式版:0.x → 1.x 一年磨一剑
⑥ 2026-07-31 · Hermes Skill 官方榜单 · 2026.07 完整数据复盘
⑦ 2026-07-30 · OpenRouter 7 月复盘:4 平行宇宙 + 4 中国黑马
⑧ 2026-07-23 · Hermes 4 月模型榜:9 大发布速览
⑨ 2026-07-20 · aie 1.7 万星:一行命令把 AI 工作流拉到自己电脑
⑩ 2026-07-17 · Opus 4.8 + Agnes Code:8 章完整复盘
⑩ 2026-07-17 · Opus 4.8 + Agnes Code:8 章完整复盘
如果这篇对你有帮助,,让更多科研朋友看到。留言区聊聊:你用 AI 帮科研时,被幻觉坑过几次?
更多技术干货,关注公众号 丁卯生人(mp.weixin.qq.com/s/dingmaoshengren-home)每周更新。
— 六六爸比