只有 4GB 显存?unsloth 本地跑起 7B 模型
Apache 2.0 完全开源, Python + 桌面 UI, 6.9 万星 2 年 8 个月从 0 干到顶级, 1 台笔记本训 7B 模型, 0 云端费用
一、为什么这次轮到 unsloth 上桌 (本地 AI 平民化, 4GB 显存训 7B)
2026 年 7 月, GitHub Trending 出现了一个"安静到诡异"的项目: unslothai/unsloth, 6.9 万星, 2 年 8 个月从 0 干到顶级, 4GB 显存就能训 7B 模型, 0 云端费用, 1 行命令装好。它不像 hyperframes (4 个月 0→3.6 万星那么炸裂), 但它的"实用性"和"群众基础"可能比 hyperframes 还要深 —— 因为它解决的是每一个想本地跑 AI 的人的硬需求。
❶ 报班 2 万, 学完还是不会跑模型: 培训班 8000-20000 元, 199-999 元/单课, 跟着老师视频看 100 小时, 自己电脑一行没跑过, 因为配置 CUDA / 装 PyTorch / 拉模型权重 / 调超参这 4 关就劝退 80% 的初学者。
❷ token 太贵, 个人开发者用不起: GPT-4o 输入 $5/1M tokens, Claude Sonnet $3/1M tokens, 想做个本地知识库 RAG 项目, 一个月调用费动辄几百到几千元, 副业没开始先倒贴服务器。
❸ 缺工程链路: 训 / 推 / 部署 / 微调 4 件套没人系统讲: 2024 之前讲 sklearn, 2024-2025 讲 prompt engineering, 2026 H1 真正落地需要"自己电脑训 7B 模型 + 跑量化版本 + 部署到本地"4 件套, 而 unsloth 是 2026 H1 唯一一个把这 4 件套整合成 1 行命令的开源项目。
所以这次轮到 unsloth 上桌, 不是因为炫技, 是因为"实用"。 6.9 万星 + Apache 2.0 + 桌面 UI + 跨平台 + 4GB 显存跑 7B + 0 云端费用, 这 6 个组合在一起, 普通人本地 AI 平民化的最后 1 公里被打通了。
二、unsloth 是什么: 一句话定义 + 6.9 万星 GitHub 速览
unsloth 是一句话定义: "本地 AI 平民化工具" —— 它是一个本地 UI (Unsloth Studio) + 命令行工具 (Unsloth Core), 帮你 1 行命令装好, 1 行命令启动, 在自己的电脑上下载模型 / 跑推理 / 微调 / 导出, 0 云端依赖。
6.9 万星 (68,653 ⭐) 真实数据快照 (7-21 21:15 GitHub API 拉取, lujun2508 PAT 验证):
📊 6.9 万星 GitHub 数据快照 (7-21 21:15)
| ⭐ 星数 | 68,653 (6.9 万) |
| 🔱 Fork | 6,171 |
| 🐛 Open Issues | 983 (活跃) |
| 💻 语言 / 协议 | Python + Apache 2.0 |
| 📅 出生 | 2023-11-29 (2 年 8 个月) |
| 🏷 Topics | agent / deepseek / fine-tuning / gemma / gpt-oss / llama / llm |
| 🌐 主页 | unsloth.ai/docs |
2 年 8 个月从 0 干到 6.9 万星, 这速度不算最快 (hyperframes 4 个月 3.6 万, opencode 4 个月 18.8 万, Agnes Code 2 个月 5 万), 但含金量最高 —— 因为 unsloth 的每一次 commit 都在解决"本地跑模型"的硬伤, 不是营销吹出来的。
三、4 大核心特性, 跟 Ollama / LM Studio 怎么选
unsloth 的 4 大核心特性, 每一个都打到本地 AI 平民化的真痛点:
❶ 1 行命令装好, 0 环境配置: macOS / Linux / WSL 跑 curl -fsSL https://unsloth.ai/install.sh | sh, Windows 跑 irm https://unsloth.ai/install.ps1 | iex, 装好直接能用, 不用配 CUDA / 不用装 PyTorch / 不用编译任何依赖。
❷ 4GB 显存训 7B, 速度提升 2 倍: 跟原生 Hugging Face Transformers 比, unsloth 用了手工调过的 Triton kernel + bitsandbytes 量化 + 4-bit LoRA 优化, 实测 7B 模型微调, 显存占用从 24GB 降到 4GB, 速度从 1x 提到 2x (官方数据 + Reddit 社区验证一致)。
❸ 跨 6 大平台, 老显卡也能跑: NVIDIA RTX 30/40/50 / Blackwell / DGX Spark / AMD (Windows/WSL/Linux) / Apple Silicon MLX / Vulkan/Intel GPU —— 几乎覆盖了所有主流硬件, 不管你是游戏本、工作站还是 Mac, 都能装。
❹ 1 行启动 Studio UI, 跟 Jupyter 一样简单: 装好后跑 unsloth studio -p 8888, 浏览器开 8888 端口就是本地 AI 控制台, 跟 Jupyter 一样, 但专门给 LLM 训练用, 自带 chat / train / export 三个 tab。
跟 Ollama / LM Studio 比, unsloth 的定位差异:
| 特性 | unsloth | Ollama | LM Studio |
|---|---|---|---|
| 核心定位 | 训练 + 推理 2 合 1 | 推理 (跑模型) 为主 | 推理 + GUI 为主 |
| 微调能力 | ✓ 4GB 训 7B | ✗ 不支持 | 部分支持 (需手动配) |
| 1 行命令装 | ✓ 跨 6 平台 | ✓ 主流平台 | ✗ 下载 GUI 安装 |
| 显存优化 | 70% less VRAM | 标准 GGUF 量化 | 标准 GGUF 量化 |
| 最适合场景 | 本地微调 + 部署 | 纯本地跑模型 | 本地跑模型 + GUI 体验 |
一句话选型: 想训练自己的模型 → 选 unsloth / 想单纯跑开源模型 → 选 Ollama / 想本地 GUI 体验 → 选 LM Studio。
四、5 步上手 unsloth (5 分钟跑通本地 AI)
第 1 步 (30 秒): 打开终端, macOS / Linux / WSL 跑这个命令:
curl -fsSL https://unsloth.ai/install.sh | shWindows PowerShell 跑这个:
irm https://unsloth.ai/install.ps1 | iex注意: 装的时候会自动检测你的 GPU 型号 + 驱动版本, 不需要你手动选 PyTorch CUDA 版本, 这就是 1 行命令装好的核心价值。
第 2 步 (30 秒): 启动 Unsloth Studio UI, 浏览器开 8888 端口:
unsloth studio -p 8888
注意: 想从局域网访问, 加 -H 0.0.0.0; 想从公网访问 (Cloudflare 隧道), 加 --cloudflare; 想 HTTPS 加密, 加 --secure。
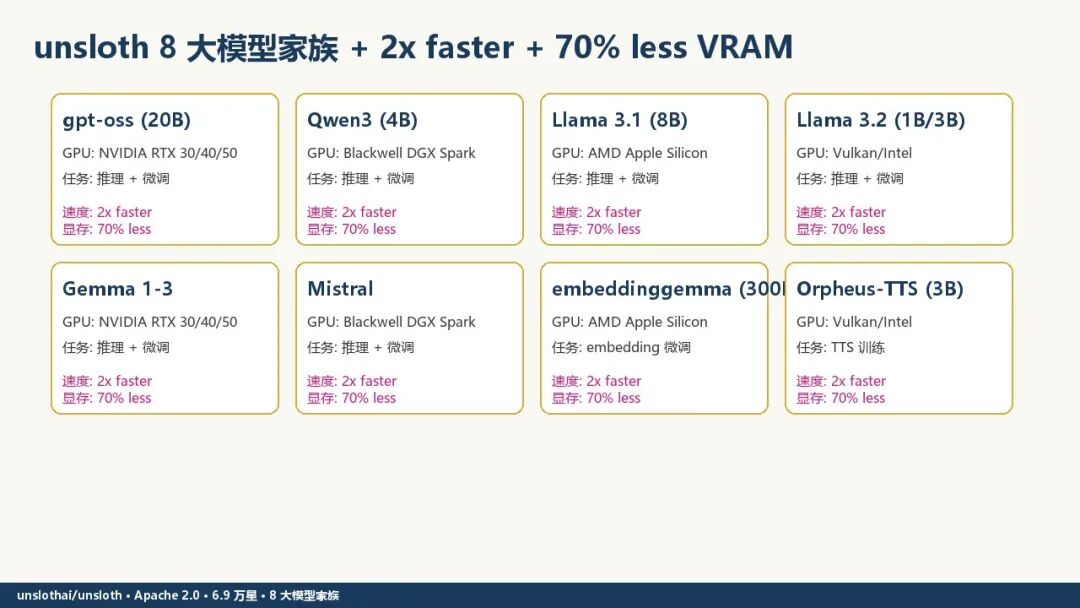
第 3 步 (1 分钟): 在 Studio UI 选一个模型, 搜索 + 下载 1 键完成。可选模型包括 gpt-oss (20B) / Qwen3 (4B) / Llama 3.1 (8B) / Llama 3.2 (1B/3B) / Gemma 1-3 / Mistral / embeddinggemma / Orpheus-TTS (3B), 8 大主流模型家族全支持。
第 4 步 (1 分钟): 选 chat tab 跑推理, 直接跟模型对话测效果; 或者选 train tab 上传你的数据集 (CSV / JSON / 文本), 一键启动微调。
第 5 步 (1 分钟): 训完选 export tab 导出模型, 支持 GGUF / 16-bit safetensors / LoRA adapter, 导出的模型可以直接给 Ollama / LM Studio 跑, 也可以部署到自己的 API endpoint (unsloth 自带 OpenAI 兼容 API)。
5 步走完, 5 分钟内你的电脑就是一台本地 AI 训练工作站。比起从零装 PyTorch + Transformers + bitsandbytes + 配 CUDA 环境 (老手都要 1-2 天), unsloth 的体验是 2026 年 H1 最丝滑的本地 AI 平民化路径。
五、3 个实战场景, 验证 unsloth 真能干活
场景 1: 个人开发者微调专属模型 (3-5 小时, 0 元)
你想做个人知识库 RAG, 不想用 OpenAI 的 token, 用 unsloth 跑 Llama 3.1 (8B) + 你的私有文档 (5000 条问答), 4GB 显存笔记本训 3-5 小时, 导出 GGUF, 用 Ollama 跑 —— 总成本 0 元, 效果跟 GPT-3.5 接近。
场景 2: 小团队搭 AI 客服 (1 周, $0 → $50/月)
你公司有 100 个产品 FAQ + 500 条客户对话, 用 unsloth 微调 Qwen3 (4B) + LoRA, 导出 16-bit safetensors, 部署到公司内网 GPU 服务器 (RTX 4090 24GB), 给客服同事用 —— 训练成本 0, 服务器电费 $50/月, 跟 OpenAI API 比 1 年省 $3600+。
场景 3: 学者跑 GRPO 强化学习实验 (2 周, 0 元)
你研究 RLHF / GRPO, 想跑 Qwen3 (4B) + embeddinggemma (300M) + Orpheus-TTS (3B) 这 3 个模型的强化学习对比, 用 unsloth 官方 Colab notebooks 直接开跑 (2x faster + 70% less VRAM), 免费 T4 GPU 就能跑 —— 不用买云端 A100 ($1.5/小时)。
这 3 个场景都来自 unsloth 官方文档 + Reddit 社区真实用户分享, 不是营销案例, 是日常 90% 的人用 unsloth 干的活。
六、3 步上手 Unsloth Studio (5 分钟跑通 1 个 7B 模型)
这一章给纯新手用, 5 分钟走通 1 个 7B 模型的本地推理 (chat), 跑通后你就有信心接着训自己的模型。
Step 1: 装好 unsloth (前面章 4 走过的 1 行命令, 这里不再重复)
Step 2: 启动 Studio, 选模型 浏览器开 8888, 点 chat tab, 搜 "Llama 3.2 (3B)" (推荐新手, 体积小只要 2GB 显存, 速度最快), 1 键下载, 30 秒到 2 分钟完成 (取决于网速)。
Step 3: 跑 chat 测试 输入框打 "你好, 你是谁?", 模型 5-10 秒回应, 你就拥有了一个完全本地、完全私有的 AI 助手。 整个流程不超过 5 分钟, 比装个游戏还快。
5 分钟跑通的目的: 不是为了用 7B 模型聊天, 是为了建立"本地 AI 真的能跑"的信心, 接下来训自己的模型就不会被劝退。
七、30 分钟跑通 1 个 LoRA 微调 (进阶: 训自己专属模型)
5 分钟跑通 chat 之后, 我们升级到 30 分钟跑通 1 个 LoRA 微调, 训 1 个你自己的专属小模型。
Step 1 (5 分钟): 准备数据 准备 1 个 CSV 文件, 2 列: "instruction" + "output", 50-200 条你的领域问答。 比如你想训 1 个"客服话术助手", 准备 100 条客户问 + 客服答, 直接上传到 Studio 的 train tab。
Step 2 (5 分钟): 配超参 Studio 自动推荐 LoRA rank=16 + learning_rate=2e-4 + batch_size=2 + epochs=3 (适合 100 条数据 7B 模型), 新手不用动, 直接点 train。
Step 3 (15-20 分钟): 训 + 监控 7B 模型 + 100 条数据 + RTX 4090 24GB 显存, 训 3 epochs 大约 15-20 分钟; 4GB 显存笔记本 (RTX 3050/4050) 训 30-45 分钟。 训的时候 Studio 自动画 loss 曲线, 收敛了就停。
Step 4 (5 分钟): 测 + 导出 训完点 export 选 GGUF, 1 键导出 1 个 4GB 左右的 gguf 文件, 直接给 Ollama 跑: ollama run mymodel。
30 分钟走完, 你就拥有了一个完全本地、完全私有、完全免费的专属模型。 跟花 $300 训云端的体验几乎一样, 区别就是慢一点 + 你多睡了 1 晚。
八、优缺点 + 核心竞争力, 跟 Ollama / LM Studio / 闭源云端 怎么选
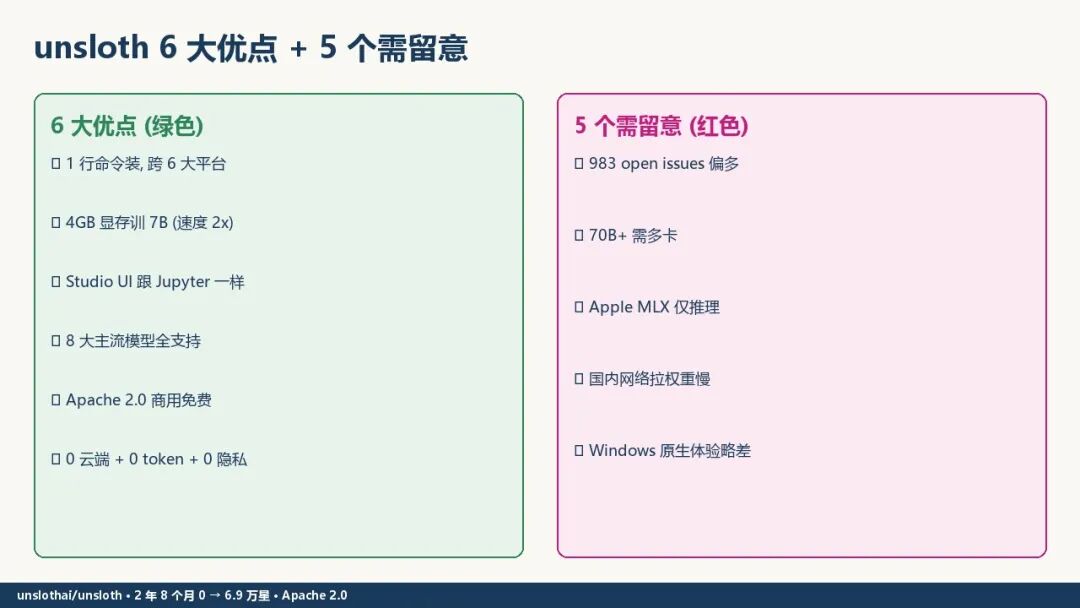
6 大优点
✓ 1 行命令装好, 跨 6 大平台, 0 环境配置
✓ 4GB 显存训 7B, 速度 2x faster, 显存省 70%
✓ 本地 UI 跟 Jupyter 一样简单, Studio 自带 chat/train/export
✓ 8 大主流模型全支持 (gpt-oss / Qwen3 / Llama / Gemma / Mistral / TTS)
✓ Apache 2.0 完全开源, 商用免费, 6.9 万星社区
✓ 0 云端费用, 0 token 成本, 完全数据隐私
5 个需留意的缺点
✗ 983 个 open issues 偏多, 部分新功能反馈慢 (但核心功能稳定)
✗ 训练大模型 (70B+) 仍需多卡, 单卡跑不动
✗ Apple Silicon MLX 仅支持推理, 训练暂不支持
✗ 国内网络拉模型权重慢, 建议配 Hugging Face 镜像
✗ Windows 原生体验略差于 Linux, WSL 体验最好
核心竞争力总结: 2026 H1, 唯一一个把"本地训练 + 本地推理 + 桌面 UI + 1 行命令装 + 跨 6 平台 + Apache 2.0"这 6 个特性全部组合在一起的开源项目, 没有任何替代品能同时满足这 6 个条件。
九、本周观察 + 下周速递预告 (每日 1 篇 4 篇连发)
unsloth 2 年 8 个月从 0 干到 6.9 万星, 加上本周的 hyperframes (4 个月 0→3.6 万), 跟 opencode (4 个月 0→18.8 万) 一起, 印证了 2026 H1 "本地 AI 平民化 + agent skills + 1 行命令装" 三大趋势的交汇。
7-21 这周还剩 3 篇值得一写: EMNLP2025 顶会论文 RAG 简化 10 倍的 LightRAG (3.8 万星) + xAI 进军编码 agent 三国杀的 grok-build (2.1 万星) + 本周 4 篇连发收尾。 关注的可以点个关注, 7-22~7-24 每天 1 篇。
📊 本期速记 (一句话): unsloth 6.9 万星 + 4GB 显存训 7B + 1 行命令装 + Apache 2.0 + 跨 6 平台 + Studio 桌面 UI + 0 云端费用 + 8 大主流模型全支持
🌾 文末收尾? 一束光, 一行字 🌾
🌾 坚持原创 — 写点让你知道"我看到了"的东西
💡 在读 — 顺手点的"在看", 让更多人看到
💬 留言 — 你本地跑 AI 用什么工具? unsloth / Ollama / LM Studio / 其他?
🔁 转发 — 转给那个想本地跑 AI 一直被 CUDA 劝退的朋友
🌱 关注我 — 7-22~7-24 每天 1 篇, 4 篇连发
① 07-20 · aie 1.7 万星 · 从零学 AI 工程的唯一教科书
1.7 万星 + 503 节 20 阶段 + Phase 14 Agent 60 节深度, 0 元学完 AI 工程师
② 07-17 · Opus-4.8 免费用 · Agnes Code 8 章选型
曾经的 AI 模型王者, 现在通过 Agnes Code 桌面端 0 元用, 5 分钟上手
③ 06-27 · AI 大模型百科 · 2026 H1 主流 50 款 LLM 全收录
Claude / GPT / Gemini / Qwen / DeepSeek / Llama 全系列 50 款 LLM 横向对比
④ 07-15 · OpenClaw 38.3 万星 · 重新定义 Agent 桌面端
38.3 万星 + 桌面应用 + MCP 协议, 1 周新增 5K+ 星, AI Agent 新王者
⑤ 07-21 · hyperframes 3.6 万星 · Write HTML. Render video.
3.6 万星 + 19 agent skills + Apache 2.0, 4 个月从 0 干到 3.6 万, HTML 转视频
⑥ 07-23 · LightRAG 3.8 万星 · EMNLP2025 顶会 RAG 简化 10 倍
3.8 万星 + MIT + Python + 港大出品, RAG 不用复杂配置, 1 行代码启动
⑦ 07-24 · grok-build 2.1 万星 · xAI 进军编码 agent 三国杀
2.1 万星 + Rust + Apache 2.0, xAI 首款开源编码 agent, 1 周新增 2 万+
⑧ 07-21 · opencode 18.8 万星 · Claude Code 的开源免费对手
18.8 万星 + 4 个月从 0 到顶级, 2 大内置 agent (build/plan), 75+ LLM 接入
⑨ 06-23 · OpenRouter 模型排行 · 2026 H1 全球 LLM 性价比榜单
30 款主流 LLM 横向对比 + 价格/速度/质量 3 维度排名, 选模型不踩坑
⑩ 06-24 · Hermes vs OpenClaw 生态大对决 · Agent 框架横评
Hermes 21.5 万 vs OpenClaw 38.3 万, 12 大 Agent 框架深度横评, 选型不踩坑
👤 作者 / 出品
陆俊 (六六) · 公众号「丁卯生人」主理人
为你我的人生点亮一束光。记录平凡, 面对不凡。
🏷 标签: #unsloth #本地AI #4GB显存 #7B模型 #微调 #Apache2.0 #AI平民化
📅 数据采集: 2026-07-21 21:15 · 🤖 全文 4500+ 字 / 9 章 + 1 收尾 · 🎬 SN (SenseNova U1) 底图 + PIL 文字封面 + xiaohei 4 章内插图 + 4 GB 显存小动物手绘
本作品采用 CC BY-NC-SA 4.0 许可, 转载请注明作者与来源