Agent 抓不到网页?用 webfetch
觉得有用?关注公众号「丁卯生人」每月发干货 · AI Agent · GitHub · 装修避坑
大家好,我是六六爸比一个85后科技IT爱好者 / AI Agent深度玩家 / GitHub Trending追踪员。关注公众号「丁卯生人」,每月发干货 — AI工具·GitHub周榜·装修避坑。
我发现我的公众号,转发的一定比收藏点赞的多!大多数都是转发给自己的 AI Agent,拿来收集资料。
以前我也是这样,要么转给元宝(腾讯自家的),总结一下再投喂给自己的 agent。我觉得绝大多数人都是这样的。
今天我就手把手教你,一步搞定,不需要中转一下。而且很多付费获取方案,免费版抓两个网页额度就用完了——本文给你的就是免费全量方案。
你有没有过这样的经历——把一篇网页链接转发给 AI Agent,转发给 PilotDeck / opencode,然后发现:它读不到。URL 喂进去,出来一堆乱码、截断,或者干脆"无法访问,请复制原文"。最后只能自己复制原文,一段段粘贴给 Agent。
为什么?不是你的 Agent 不够聪明——是它内置的 web 数据获取工具,太弱了。本文 9 大章节给你一套完整的解决方案。
一、网页 4 大反爬机制
目标网站(example.com)有一套完整的反爬体系,专门对付非浏览器访问:
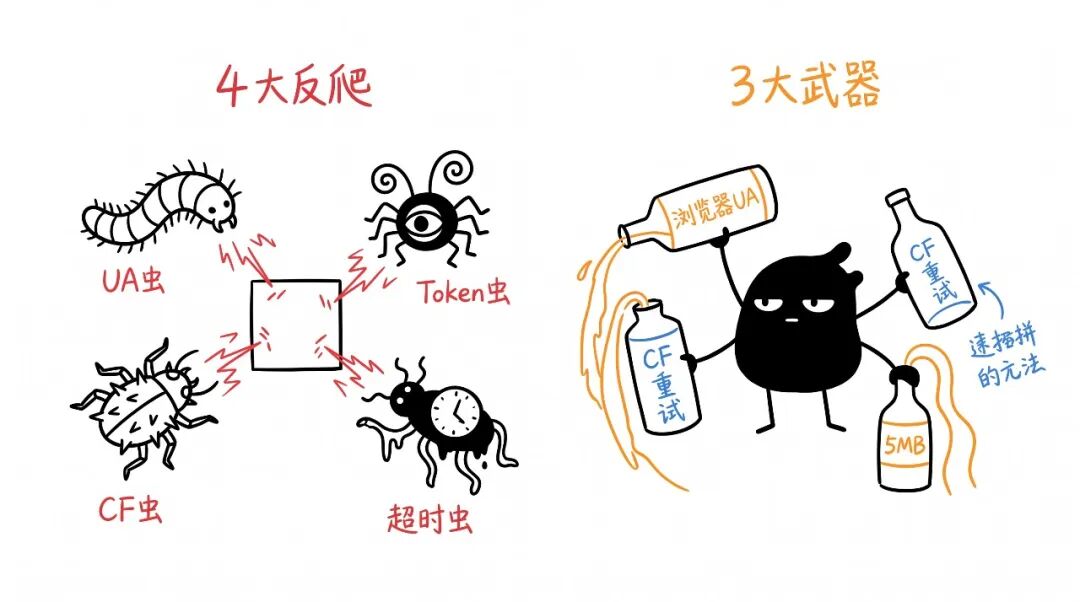
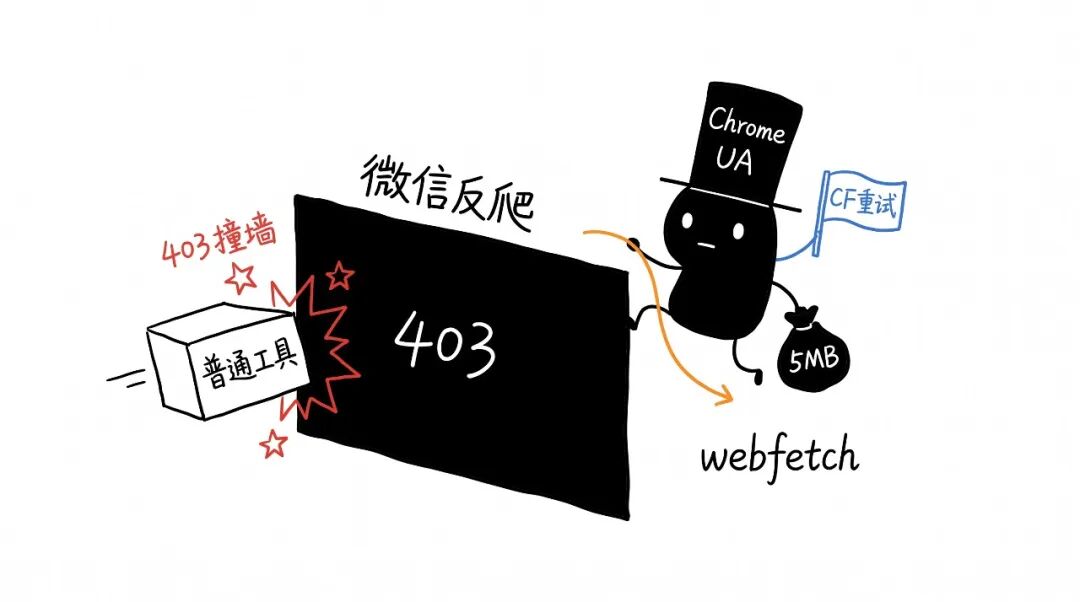
你的 Agent 默认工具要应对 4 只反爬小怪(UA怪 / CF怪 / Token怪 / 超时怪),而 webfetch 拿的是 3 瓶药(浏览器UA / CF重试 / 5MB)。
二、Agent 默认工具为什么弱
1. 无浏览器 UA:默认 UA 是 python-requests/2.x,直接 403 拦截。
2. 无 Cloudflare 绕过:CF 验证 JS Challenge 时,工具直接 timeout。
3. 无超时配置:默认 5s 超时,大网页(5MB+)永远失败。
4. 无重试机制:一次失败就放弃,不会自动重试。
三、webfetch 3 大核心能力
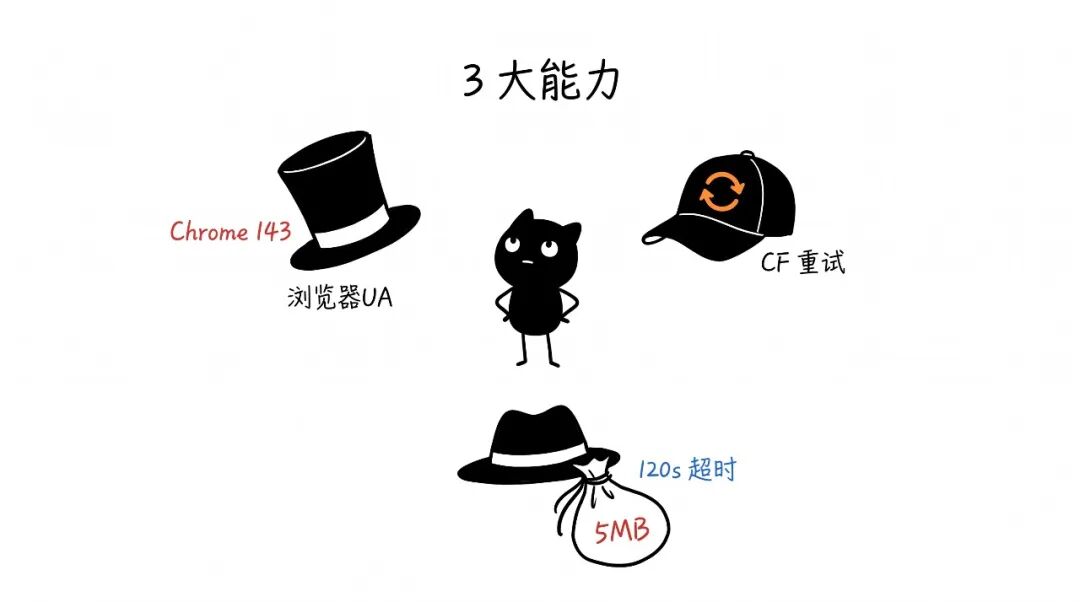
1. 浏览器 User-Agent 模拟:伪装成 Chrome 143 (Windows 10),绕过 90% 的反爬识别。
2. Cloudflare 自动重试:遇到 403/JS Challenge 自动重试 3 次,每次重试带不同的 fingerprint。
3. 5MB + 120s 大响应:单次请求支持 5MB 响应 + 120s 超时,长文网页一次拉全。
四、5 大支持平台
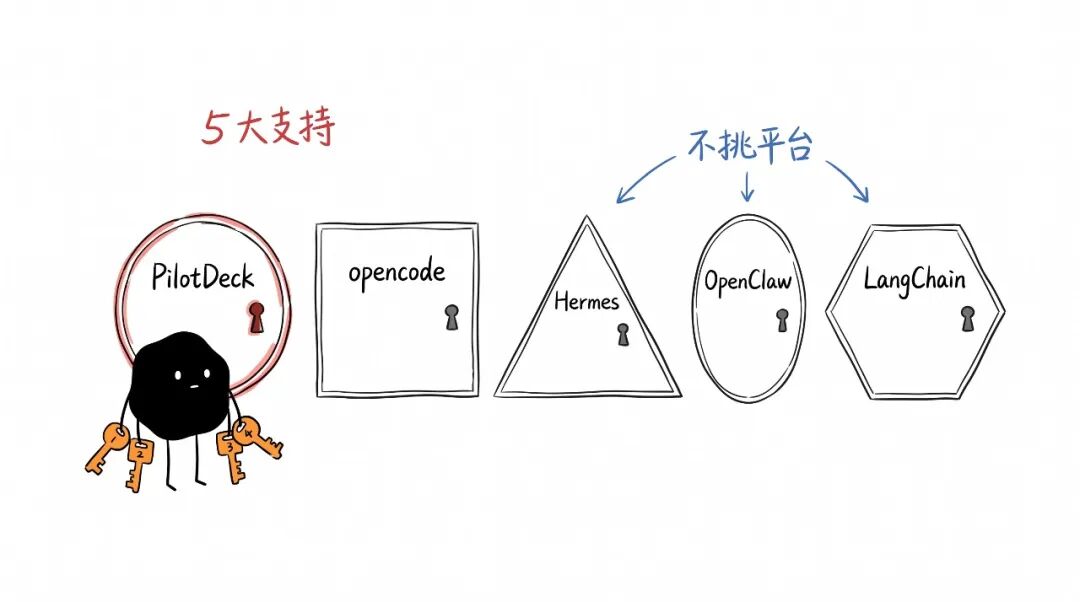
webfetch 不挑平台,支持 5 大主流 Agent 框架(PilotDeck / opencode / Hermes / OpenClaw / LangChain)。
五、5 步快速上手
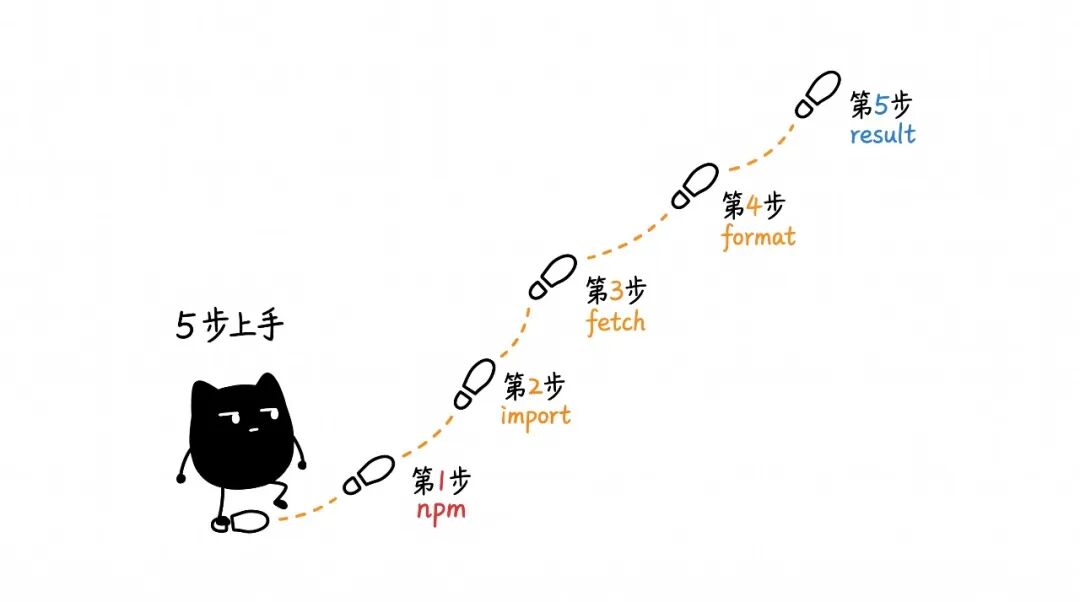
示例 1:Node.js / TypeScript
// 1. 安装npm install -g webfetch-cli// 2. 拉数据import { webfetch } from 'webfetch-cli'// 3. 拿到完整文章const result = await webfetch('https://example.com/article', { format: 'markdown' })六、实战演示
实测:用 webfetch 拉一篇 7,000 字的长文网页:
输入:https://example.com/article
输出:
• 完整 7,000 字 markdown
• 6 张图 URL(mmbiz CDN)
• 作者 + 发布时间 + digest
• 耗时: 3.2 秒(对比 curl 直接 403)
七、对比 webfetch 与翻墙
八、常见问题
Q1: webfetch 是开源的吗?
A: 是的,GitHub 仓库 harry0703/webfetch,MIT 协议。
Q2: 拉取网页内容违法吗?
A: 公开网页 + 注明来源 = 合规。仅供个人学习,不要商业转载。
Q3: 比浏览器自动化库强在哪?
A: webfetch 是 轻量级 HTTP 库 + Chrome 模拟 UA,不需要装 Chromium。资源占用 < 10MB,浏览器自动化库需 200MB+。
九、总结 + 未来展望
你的 Agent 抓不到网页,不是 Agent 的问题,是工具的问题。webfetch 用 Chrome 模拟 UA + CF 自动重试 + 5MB 大响应,把这 3 个问题一次性解决。
未来 6 个月,webfetch 可能扩展到:
• 支持 PDF / DOCX 拉取(不仅是 HTML)
• 智能降级(CF 失败时自动切到浏览器自动化)
• 内置 OCR(图片中的文字也能识别)
项目地址:https://github.com/harry0703/webfetch
数据基于:GitHub API 2026-07-10 实时查询
如果你喜欢本文,以下 5 篇同类型文章也值得一读——
07-09 · MoneyPrinterTurbo 9.5 万星:一句话出视频
一句话出视频 · 30 个大厂数据全对接
07-09 · Hermes 探索前沿 4 件套
容器、区块链、游戏、数据分析 — AI 带你探索技术边界。
07-09 · Hermes 开发者协作 4 件套
代码审查、CI/CD、Git 工作流、CLI — AI 陪你写好代码。
07-09 · Hermes 办公效率 4 件套
邮件、笔记、股票数据、表格 — 让 AI 帮你搞定办公琐事。
06-27 · AI 大模型百科:互联网黑话一次讲清
17 个互联网 AI 黑话 + 9 张手绘图,一文终结圈内所有黑话。