OpenAI Codex 橙皮书·第六篇·双线对比
这是 Codex 橙皮书连载的最后一篇。前 5 篇覆盖了五种形态、CLI 深度、AGENTS.md、桌面 App + Cloud + 四大扩展。这一篇收尾:用一个完整的实战把前面所有能力串起来,再讲 Codex 和 Claude Code 双线使用的心智模型。讲完这本橙皮书就拆完了。
Codex 不是工具是系统: 5 种形态 + 10 分钟上手 ❘ Codex 完整实战手册 v2.0.1 拆给你看: 花叔第 8 本橙皮书
一、从一个想法到能跑的完整产品
花叔在书里给的标准实战案例是做一个 AI 文章摘要 Web 应用:用户粘贴文章 URL,系统抓取内容、调用 OpenAI API 生成三种长度摘要(一句话/短摘要/详细摘要),历史记录存进数据库。
为什么选这个项目:技术栈覆盖面刚好(前端 Next.js + 后端 API 路由 + 数据库 SQLite + 外部 OpenAI API),每一层可以独立开发(适合多 Agent 并行),你做完能自己用(花叔每天要读大量文章有个摘要工具真的实用)。技术选型:前端 Next.js 15 + Tailwind CSS,后端 Next.js API Routes,数据库 SQLite + Drizzle ORM,部署 Vercel 一次部署免运维。
二、阶段一:需求分析和规划(CLI Plan 模式)
打开终端进入你想存放项目的目录,启动 Codex CLI,按 Shift+Tab 切到 Plan 模式。这一步非常关键:让 Codex 先帮你想清楚再动手。
给 Codex 的 prompt:我要做一个 AI 文章摘要工具,Web 应用。核心功能:用户输入文章 URL,系统抓取文章内容,调用 OpenAI API 生成 3 种不同长度的摘要,存储历史记录用户可以回看。技术要求:Next.js 15 App Router + SQLite + Drizzle ORM + Tailwind CSS + 部署到 Vercel。请分析需求给出完整的技术方案和项目结构。
Codex 在 Plan 模式下会输出一份详细的方案包括目录结构、数据库 Schema、API 路由设计、前端页面规划。不要急着说「开始做」。仔细看方案挑出你觉得不对的地方。比如 Codex 可能会建议用 Cheerio 做网页抓取,你可以追问:Cheerio 能处理 JavaScript 渲染的页面吗?比如微信公众号文章。如果不能有什么替代方案?考虑部署到 Vercel 的限制。这种追问很重要。AI 擅长生成「看起来合理」的方案但细节上可能有坑,你的判断力在这一步最有价值。
确认方案后让 Codex 生成一份 AGENTS.md(上一篇讲过结构),在多 Agent 并行的时候每个 Agent 都会读自己工作目录下的 AGENTS.md 来理解上下文。现在花时间把它写好后面能省很多事。
三、阶段二到五:搭建、并行、集成、部署
阶段二基础搭建(CLI Auto 模式):切回正常模式设置 codex --full-auto,给它第一个任务:按照 AGENTS.md 中的方案初始化项目(create-next-app + 安装依赖 + 目录结构 + Drizzle 配置 + 写一个最简单的首页确认能跑)。让它跑完再看不要中途打断,项目初始化是一连串有依赖关系的操作打断容易导致半成品状态。跑完之后验证,让 Codex 执行 npm run dev 自己打开浏览器看一眼。这时候 commit 一次 git init && git add . && git commit -m "init: project scaffold",每个里程碑都 commit 这是保险。
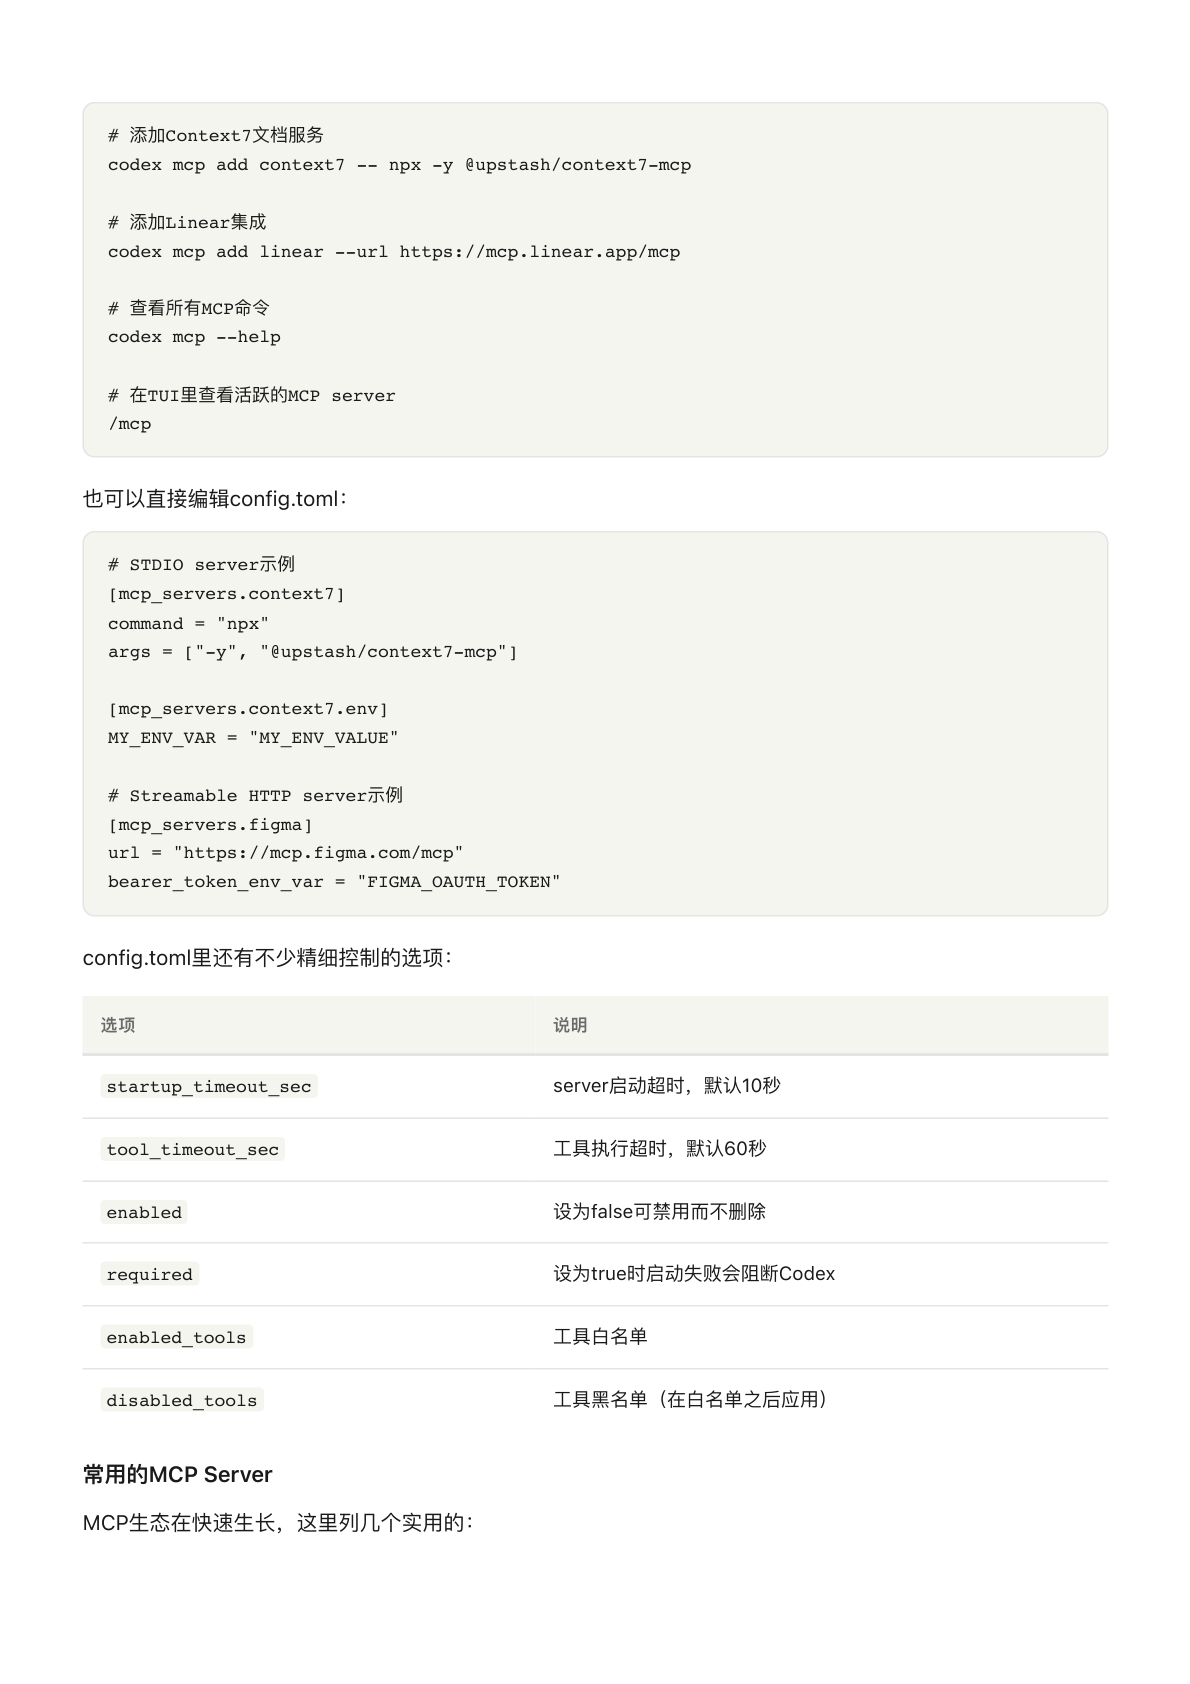
阶段三并行开发(App + Worktree):骨架搭好后打开 Codex 桌面 App,开三个并行任务每个用 Worktree 模式跑在独立分支上:Agent 1(feat/frontend-ui)负责前端所有页面和组件 15-20 分钟、Agent 2(feat/backend-api)负责 API 路由 + 文章抓取 + 摘要生成 15-20 分钟、Agent 3(feat/database)负责数据库模型 + 迁移 + CRUD 操作 10-15 分钟。
并行开发最容易出问题的地方不是代码本身而是「接口不一致」。开三个 Agent 之前先把所有接口约定写进 AGENTS.md:字段名、类型、返回格式越具体越好。这 10 分钟的约定能省后面 1 小时的对齐。比如三个 Agent 必须约定好接口契约:POST /api/summarize body { url: string }、GET /api/history、GET /api/history/:id、数据库函数 insertSummary / getSummaries / getSummaryById。Agent 1 可能调 /api/summary,Agent 2 实现的是 /api/summarize,不约定合并时就要改一堆东西。
阶段四集成和测试(CLI + Review):三个 Agent 都完成后回到 CLI 先 git branch 看三个分支状态,合并顺序有讲究:先合并底层再合并上层,数据库是最底层 API 依赖数据库 前端依赖 API,所以顺序是 database → backend-api → frontend-ui。如果遇到冲突不要慌让 Codex 帮你解决。合并完成后跑 npm run dev 大概率会报错(正常,三个 Agent 各自用 mock 数据开发真正对接时类型可能不匹配)。这时候用 /review 命令做一次代码审查,Codex 会检查整个项目的代码找出类型错误、未使用的导入、不一致的命名。逐个修复每修一个验证一下。测试通过后 commit 并打 tag git tag v0.1.0。
阶段五优化和部署:核心功能跑通后还有收尾工作适合丢给云端 Codex 异步处理:写 README.md、优化错误处理、添加 SEO 和性能优化。云端 Codex 的好处是这些任务可以同时跑每个在独立的沙盒环境里执行完成后给你提 PR,你审查合并就行。部署到 Vercel 非常简单,推代码到 GitHub 在 Vercel 控制台导入项目配置环境变量点 Deploy。唯一需要注意的是 SQLite,Vercel 的 Serverless 环境不支持持久化文件系统,让 Codex 帮你迁移到 Turso(libSQL 的云端版本):本地开发仍然用 SQLite 文件、生产环境用 Turso、通过环境变量 DATABASE_URL 区分。
花叔的产品开发经验三条原则:不要一次给 AI 太大的任务(「帮我做一个 AI 文章摘要工具」是糟糕的 prompt,「帮我实现 POST /api/summarize 路由接收 URL 参数用 Cheerio 抓取正文调用 GPT-5.5 生成三种长度的摘要」是好的 prompt,任务越具体 AI 的输出越可控)。每一步都验证(骨架搭好验证一次数据库建好跑一遍测试 API 写好 curl 测一下,每一步验证的成本很低但等出了问题再回头查成本就高了)。最重要的能力不是写 prompt 是判断 AI 的输出质量(AI 写的代码看起来总是很有道理它不会跟你说「我不确定这样做对不对」,你得自己判断这个数据库 Schema 合理吗这个错误处理够不够这个 API 设计后续好扩展吗)。
四、Codex vs Claude Code:双线心智模型
先纠正一个常见误解:很多人觉得 Claude Code 只是一个终端工具 Codex 是多形态的全能选手。这个对比在 2026 年初或许成立,但到 2026 年 5 月已经不准确了。Claude Code 也是多形态的:终端 CLI、桌面 App、VS Code 和 JetBrains 扩展、claude.ai 网页和移动端、GitHub Action 自动开 PR。2026-05-11 发布的 v2.1.139 更是把 Codex「长任务自治」的护城河抹平了一大块,新加了 claude agents 多会话面板和 /goal 持续目标命令。所以「单形态 vs 多形态」这个对比框架是错的。两个工具都在快速进化功能上有大量重叠,真正的差异藏在模型选型、长上下文真实表现、生态侧重和默认风格里。
2026 年 5 月模型对照表:SWE-Bench Verified(理想单文件单 issue 场景)Codex GPT-5.5 是 82.6% Claude Opus 4.7 xhigh 是约 80.9%,Codex 微弱领先。SWE-Bench Pro(真实 GitHub issue 场景)Opus 4.7 是 64.3%,GPT-5.5 是 58.6%,差了将近 6 个百分点,Claude 赢在真实工程任务。Terminal-Bench 2.0(终端命令操作连续多步 agent 任务)Codex 82.7% vs Claude 69.4%,差了 13 个百分点 Codex 大幅领先终端任务。
最值得读的还有 1M 上下文陷阱:Opus 4.7 最大的新闻是「1M 原生上下文 + 取消 long context 溢价」,但 Anthropic 自己的系统卡里藏了一条不太被注意的事实:Opus 4.7 在 1M 上下文里的 MRCR v2 8-needle 检索能力从 4.6 的 78.3% 退到了 32.2%。这意味着上下文越长新模型「记住关键细节」的能力反而退步。1M 上下文不等于可以放心把整个代码库丢进去让 Opus 4.7 一次性消化。处理大代码库的时候文件选择的「外科手术式」精度比一次塞进去更多文件更重要。
五、Codex 独有 vs Claude Code 独有(2026-05 版)
Codex 独有:Computer Use(桌面 App 自带光标操作本机其他 App 多 agent 并行)、In-App Browser + Chrome 扩展(从 localhost 网页到登录态网页两段都覆盖)、Automations 续跑(跨天/跨周的长任务调度)、@codex GitHub 原生集成(在 PR/Issue 评论里 @codex 直接触发云端任务)、ChatGPT 账号共享(一个 Plus/Pro 订阅同时覆盖 ChatGPT 和 Codex)、CLI 开源(Rust + Apache-2.0 可以自己改自己分发)。
Claude Code 独有:1M 原生上下文取消溢价(但要警惕 MRCR 退步)、SKILL.md 官方插件市场(Excel/PowerPoint/Word/PDF 四件套预置 skill,外加 5 月一次性放出的法律行业 20 多个 MCP 连接器 + 12 个法务垂类插件金融服务 10 个 agent 模板)、Hooks 生命周期粒度更细(PreToolUse / PostToolUse / compaction 钩子链都有)、Surface-agnostic(同一个 agent 跑 shell / VS Code / JetBrains / GitHub Action / claude.ai web 和移动端状态打通)、Token 经济性(第三方实测同任务 Codex 用 188K token、Claude Code 用 33K token,约 5.5 倍差距)、JetBrains 生态(JetBrains 2026-04 调研里 most loved 46%)。
六、双工流落地清单
devtoolpicks.com 的综合评测把双工流总结成一句话:Codex for keystroke, Claude Code for commits。
Codex 负责键盘连击式的快速产出:已经想清楚要做什么让 agent 快速实现;跑测试、改配置、写脚本、批量重命名文件这种 fire-and-forget 任务;长程自治任务(Automations 续跑 + /goal 多日工作流);需要直接操作网页和本机 App 的任务(Chrome 扩展 + Computer Use);所有「目标已经明确只差执行」的活。
Claude Code 负责 commit 级的决策:架构讨论、技术选型、复杂重构方案;大代码库的精准修改(外科手术式文件选择);需要先问几个澄清问题才能动手的活;需要写文档写注释写 PR description 这类「需要拿捏措辞」的活;所有「目标还没明确需要一起想清楚」的活。
七、三种组合黄金模式
模式一:Claude Code 探索 + Codex 执行。遇到新代码库或复杂需求时先用 Claude Code 来理解,它默认会问澄清问题配合更稳的方法论让你不容易在错误的方向上跑太远。方案确定后切到 Codex 去并行执行具体修改。Claude Code 负责「想清楚」Codex 负责「快速干」。花叔写橙皮书系列时经常用这个模式:先让 Claude Code 读完整个项目的 fragments 目录理解全书结构和风格,和他一起拍板修订方向,然后把具体的章节修订任务分配给 Codex 的多个 agent 并行跑。
模式二:Codex 日常 + Claude Code 深潜。日常开发和维护用 Codex 它快、生态好、GitHub 集成顺畅大部分常规任务都能搞定。但遇到那种「需要想很久才能理清逻辑」的问题时切 Claude Code。Opus 4.7 在 SWE-Bench Pro 这种「真实 GitHub issue」任务上仍然稳一些,xhigh effort level 处理复杂编程任务的稳定性目前是他用过的编程模型里最好的之一。
模式三:Codex 自动化 + Claude Code 手动。把那些可以标准化的任务交给 Codex 的 Automations:每天自动扫代码质量、每次 PR 自动审查、定期更新依赖,这些不需要人盯着。需要判断力的任务留给 Claude Code 对话式处理:架构决策、技术选型、复杂重构。自动化处理「确定性高」的事,对话处理「不确定性高」的事。
八、两个警告 + 一个长期建议
警告一:Codex 配额诡异飙升。Codex 从 2026-05-10 开始多档订阅集中爆发了「配额诡异飙升」的问题。OpenAI Community 帖子 1380649 里有用户「轻量使用 1 小时就快到 weekly limit」、GitHub Issue #13186 里有用户「改一行 kitty 配置就吃掉 5h budget 的 2%」。OpenAI 在帖子里承认了 metering 异常但截至 5 月 14 日还没给出修复时间表。如果你不需要 GPT-5.5 的 Terminal-Bench 优势日常任务可以手动切回 GPT-5.4 或 GPT-5.4-mini 省额度。
警告二:不要执着于 benchmark。AI 编程工具的格局每 3-6 个月就变一次,今天的最佳实践可能三个月后就过时了。v1 橙皮书在 4 月 14 号才写完,5 月 14 号写 v2 的时候已经有大半内容要重写,所以这本书你看到的是 2026 年 5 月的快照,再往后请自行验证。关注官方 Changelog,Codex 和 Claude Code 都有 changelog 页面每次更新都列出新功能。养成每周扫一眼的习惯比看二手解读靠谱。
长期建议:两个都用保持手感。只用一个工具你会不自觉地把所有问题都往那个工具的模式上套。两个都用你才能在每个具体场景里做出更好的选择。这跟编程语言一个道理只会一种语言的人看什么问题都像钉子。
到这里这本 Codex 橙皮书 v2.0.1 的 6 篇连载就拆完了。从第一篇的「作者是谁 + 怎么读」,到第二篇的「五种形态 + 10 分钟安装」,到第三篇的「第一个项目 + CLI 深度 + Windows Full Access 警告」,到第四篇的「AGENTS.md 给 Codex 一张地图」,到第五篇的「桌面 App 五件套 + Cloud 异步 + Skills/MCP/Automations/goal 四层扩展」,再到这一篇的「从零做产品 + 双线心智模型」❘❘核心心智模型和组合策略比具体命令保鲜更久,但细节永远以官方为准。
原文信息:Codex 橙皮书 v2.0.1 §09-§10,作者花叔,GitHub alchaincyf/codex-orange-book,CC BY-NC-SA 4.0 协议。
下一篇: 书名解读+1 ❘ 第1篇-总览。下篇看点: Hermes 对位 + baoyu 反超趋势。
六六爸比(本文作者, 85 后科技 IT 爱好者), 本文首发于公众号「丁卯生人」。